
公开数据 Skills 的最小可行 Agent 技术栈

更新于
面向公开数据 Skills 的实用架构指南:Agent 客户端、MCP 运行时、统一数据层、可观测性、成本管控与故障边界。
一句话总结:这篇架构文章是各团队把对话线程里的 Skills 打磨成可持续产品的中枢:Agent 客户端、MCP 运行时、公开数据层与可观测性。
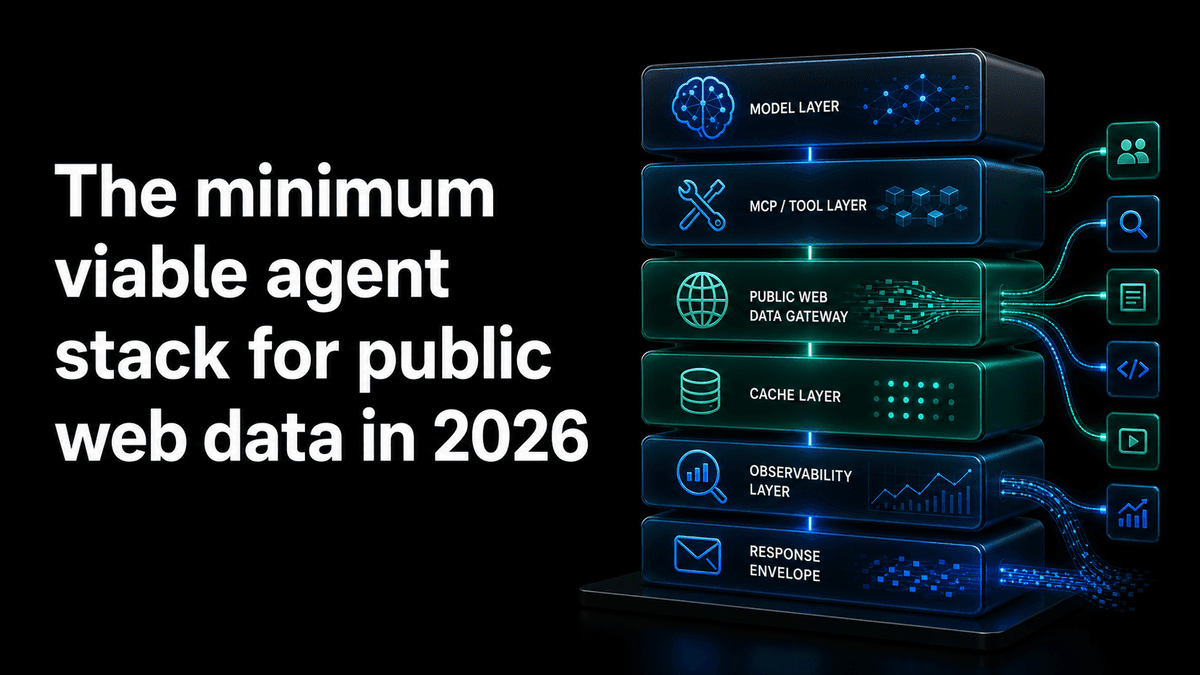
要构建一套会去调用公开数据的生产级工作流,你需要四个组件外加几道护栏:一个擅长工具调用的 Agent 产品、一个 MCP 运行时、一个统一的公开数据层、一套能看清 Agent 实际调用了什么的可观测性,以及一些让成本和范围始终可被审视的管控手段。除此之外的一切,都得先证明自己值得占一席之地。
这就是我们会为公开数据 Skills 保留的技术栈,比如 KOL 估价、创作者发现、社交监听、竞争情报和市场调研。它刻意比一张完整的 Agent 平台架构图要小,因为大多数团队都把第一个版本造得过于臃肿。
参考技术栈
| 层级 | 开发期选择 | 生产期选择 | 它必须证明什么 |
|---|---|---|---|
| Agent 产品 | Claude、ChatGPT 自定义 MCP 应用、OpenClaw、Hermes、Codex、Claude Code、Cursor、VS Code | 你的团队已经信任的那套 Agent 运行时 | 能调用工具、检视结果并修正输出 |
| MCP 运行时 | 客户端里的托管 MCP URL | 长期运行、支持 MCP 的 Agent 服务 | 稳定的鉴权、工具发现与工具执行 |
| 公开数据层 | UnifAPI MCP 与 HTTP API | 同上,外加明确的范围与预算 | 一个统一封装、一套计费模型、实时公开记录 |
| 可观测性 | 浏览器/客户端对话记录加日志 | 工具调用追踪、记录条数、延迟、成本 | 能回放为什么答案发生了变化 |
| 持久化 | 手动复制结果 | 存储运行的输入、记录 ID、输出和决策 | 能跨时间对比多次运行 |
前四层是必需的。一旦工作流被重复执行或面向客户,持久化就也变成必需。在那之前,最快的学习闭环通常是一个 Agent 线程加一份清晰的 Skill 提示词。
第 1 层:Agent 产品
模型挑选工具,运行时执行工具。只要任务和工具界面足够清晰,现代 Agent 产品不用太多提示就能处理多步骤的工具调用。开发阶段,就用你团队天天在用的那个产品:仓库内的工作用 Codex,终端和项目自动化用 Claude Code,操作型工作流用 Claude Desktop 或 Claude.ai,从编辑器里起步的工作用 Cursor。
不要一上来就造一个定制 GUI,除非这套工作流已经有了稳定的输入和重复的买家。GUI 会过早地把工作流冻结住。而一个 Skill 能让操作者追问、切换目标市场、要求更深入的检索,或在你着手把任何东西产品化之前,先让 Agent 解释一下它的置信度。
第 2 层:MCP 运行时
MCP 是 Agent 与外部系统之间的连接层。对公开数据 Skills 而言,运行时需要暴露工具、处理 OAuth 或 bearer 鉴权、显示连接状态,并让 Agent 检视可用的操作。
在我们考察过的主流 Agent 客户端里,远程 HTTP MCP 服务器如今已是云托管服务的默认形态。Claude Code 的参考文档把 HTTP 列为远程云服务器(在可用时)的推荐选项。Cursor 把 Streamable HTTP 记录为一种带 OAuth 的远程传输方式。OpenAI 的 Docs MCP 页面则展示了 Codex 如何按 URL 添加一个 Streamable HTTP MCP 服务器。
对 UnifAPI 来说,这意味着 Skill 不应要求用户安装本地爬虫或粘贴平台 API 密钥。它应该让用户连接 https://mcp.unifapi.com,在需要时用 OAuth 鉴权,并让 Agent 通过 MCP 目录去发现各项操作。
第 3 层:统一公开数据层
统一数据 API 是整个技术栈中最大的杠杆点。如果你的 Agent 最后要为 Twitter/X 调一个封装、为 Reddit 调另一个、为 YouTube 再调一个,还要靠一张电子表格来做 KOL 估价,那你在搭好 Agent 工作流之前,就先给自己造出了一个多供应商集成的难题。
把这份复杂度推到一个网关背后。UnifAPI 的实时目录用一个 MCP 服务器和一份 HTTP 契约覆盖了 TikTok、LinkedIn、Instagram、YouTube、Twitter/X、Threads、Reddit 和 Hacker News。Agent 的提示词于是从「调用 profile_api、comments_api、search_api,然后拼出一张电子表格」变成了「跑一下 KOL 估价 Skill」。
关键的产品要求不只是覆盖面,更是一致的响应行为:可预期的请求 ID、一份数据负载、可选的分页、计费元数据,以及归一化的错误。正是这些细节,让 Agent 能从部分失败中恢复,而不是凭空编出一套说法。
第 4 层:可观测性与回放
没有可观测性,你就是在盲调。一个生产级公开数据 Agent 的最低要求,是每次运行都有一条追踪记录,记下用户提示词、每一次工具调用、参数、响应状态、耗时、返回的记录条数、计费的记录条数、模型输出和最终决策。
一旦你能回放一次运行,回归问题就不再神秘。一次慢运行通常是四种原因之一:模型延迟、公开数据源延迟、一条扇出过广的提示词,或是因操作选择含糊而引发的重试循环。追踪记录应当告诉你到底是哪一种。
| 要记录什么 | 为什么重要 |
|---|---|
| 原始用户任务 | 解释意图与约束 |
| 所选操作 | 显示发现机制是否选对了数据源 |
| 查询/请求体参数 | 解释某个数据源为何返回这些记录 |
| 记录条数与计费 | 让成本可预测 |
| 分页决策 | 显示这次运行是停得太早还是太晚 |
| 置信度与假设 | 让最终答案可审计 |
第 5 层:持久化
不要在第一天就把所有东西都持久化。只持久化那些能让未来的用户理解或对比这个决策的最少事实。对一次 KOL 估价运行,存下活动输入、创作者账号、公开记录的 ID 或 URL、估价区间、置信度、假设和最终备注。对社交监听,存下查询、数据源、时间窗口、头部记录、主题和一份摘要。
陷阱在于:只保存了原始工具输出,却没保存决策上下文。未来的读者需要知道 Agent 为什么去拉取那些记录,以及这个答案本该帮助决定什么。
成本管控
公开数据 Agent 需要明确的成本管控,因为工具调用很容易迅速扇出。一个好的 Skill 会设置默认的记录预算,说清一次轻量运行的成本,并在从初筛迈向深度调研之前先征求同意。
| 管控项 | 第一个版本的默认值 |
|---|---|
| 记录上限 | 每个数据源 20-50 条记录后再询问是否继续 |
| 平台范围 | 从主平台开始,仅在需要时再扩充 |
| 分页 | 当边际记录不再改变答案时就停止 |
| 深度挖掘 | 多源扩展须经用户明确确认 |
| 输出 | 返回证据和假设,让用户自己判断更多数据是否值得 |
这套技术栈在哪里仍会失灵
第一,OAuth 接入用户自有的 SaaS 账户是一个不同的集成类别。Gmail、Linear、Notion、HubSpot 和 Salesforce 是用户授权的私有数据。UnifAPI 面向的是公开数据。用户的私有系统请用一个连接器平台或第二个 MCP 服务器来处理。
第二,长时间运行的后台工作流需要在对话线程之外做编排。每周摘要、隔夜爬取或每小时监控,都应当使用调度器、持久化队列和通知路径。Skill 可以定义任务的形态,但生产级交付需要一个执行层。
第三,当网站本身就是界面时,浏览器工作流仍然不可或缺。如果 Agent 必须登录某个门户、填写表单或在仪表盘里导航,那就用一套浏览器 Agent 技术栈。如果 Agent 需要的是可重复获取的公开记录,那就从 API 起步。
一套让你保持诚实的搭建顺序
从一个 Agent 客户端里的一个 Skill 开始。接上 UnifAPI MCP。手动跑五个真实任务。检视记录和最终输出。加上成本上限。加上追踪日志。在这之后,再把工作流产品化,藏到一个应用 UI 或定时任务背后。
顺序很重要,因为它能防止过早地堆砌基础设施。如果一个 Skill 在透明的 Agent 线程里都产出不了有用的答案,那么再漂亮的 UI 也救不了它。如果它在线程里能产出有用的答案,那么产品化的路径就会清晰得多。
已核查的来源
本架构指南于 2026 年 6 月 2 日对照以下官方资料做了更新:Model Context Protocol 简介、OpenAI Docs MCP 页面、Claude Code MCP 参考文档,以及 Cursor 的 MCP 文档。
推荐延伸阅读
MCP 目录工具设计 - 深入讲解 MCP 操作层。
统一响应封装 - 介绍这套技术栈所依赖的数据契约。
面向公开数据的 Agent First Skills - 把架构重新连回到面向用户的 Skills。