
为什么公开数据 Skills 需要一个统一的响应封装

更新于
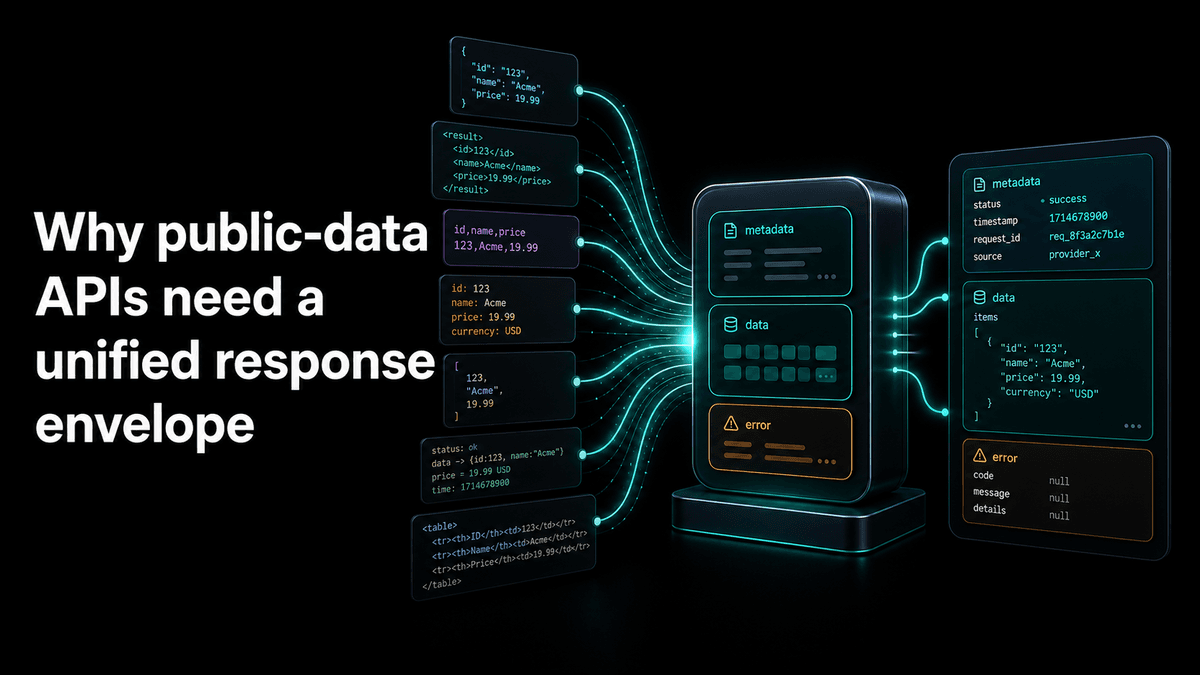
每个平台的响应结构都不同。UnifAPI 用统一的响应信封承载它们,让 Skills 能可靠地调用、比较和恢复。
一句话总结:这是一篇关于响应契约的文章:公开平台各不相同,但 Agent 需要一个统一封装来处理分页、计费、错误和记录。
每个公开数据源返回的响应形态都不一样。TikTok 用一种方式包裹结果,Reddit 用另一种,YouTube 又是一种,LinkedIn 还是一种。如果你的 Agent 直接和它们全部对话,它就继承了那全部的差异——分页逻辑分叉、重试策略分叉、错误解析分叉。我们的解法是把每一个操作都推过一个统一的封装。下面是这套 schema,以及它为什么重要。
问题所在
数据源的差异是多平台 Agent 头上一笔无声的税。Agent 的工具调用循环不得不处理众多形态,而那份复杂度会在三个维护起来昂贵的地方显现出来:提示词(模型得被教会每一种形态)、重试策略(不同的数据源在失败后以不同方式分页),以及错误封装(一个平台的「未授权」响应和另一个的长得毫不相像)。
我们眼看着自己的演示 Agent 把大部分 token 花在了「形态杂耍」上而非推理上,于是断定正确的修复点在网关,而不在 Agent。
UnifAPI 的封装
我们暴露的每一个 HTTP 端点,跨越每一个平台,返回的都是同一个外层形态:{ request_id, data, pagination?, billing }。data 内部的字段是平台专有的——一条 TikTok 视频有 hashtags,一篇 Reddit 帖子有 subreddit——但围绕它的一切都是一致的。
错误则收拢进一套封闭词汇。每个错误都带一条人类可读的消息和一个机器可读的类型。模型可以基于类型来分支判断,而不必去识别平台专有的文本。
我们采用的重整形模式
把各公开平台统一到一个封装背后,意味着我们的重整形层在每个平台上只有几百行代码。其中有三种模式占了主导。
游标统一——每个平台的分页令牌(max_cursor、after、nextPageToken、end_cursor、page)都变成 pagination.cursor。我们从数据源提供的任何信号里算出 has_more(length === limit、一个显式的 has_more 标志,或一个为空的 next-cursor)。
字段扁平化——当一个数据源把数据嵌套三层深时(data.data.children.data,说的就是你,Reddit),我们把它提到顶层的 data[]。模型从不会看到那些中间封装;它看到的是记录本身。
防御性解析——公开平台会不打招呼就改字段类型(一个计数变成了字符串、一个数组变成了单个项、一个时间戳变成了 null)。重整形层会把每个字段强制转换为它声明的类型,并仅在必填字段缺失时才丢弃该记录。正是这份纪律,捕获了我们在原样透传时见到的大多数无声故障。
如果你跳过这一步会出什么问题
没有封装,规模化时就会出两件错事。第一,你的 Agent 提示词会随平台数量线性增长——每一个新平台都要加一段话来解释它的响应形态。到第 10 个平台时,提示词就成了这次调用里最慢的部分。
第二,你的重试和分页代码会成倍增长。每一个数据源专有的怪癖都会和其他怪癖相互作用,于是「平台 X 在条件 Y 下游标后重试能不能行」的这个矩阵就爆炸了。那些没有及早归一化的团队,最终都会在 bug 出现之后才迟迟去写一个归一化层。
接下来是什么
当前的封装能干净地覆盖列表式端点。我们正在做的下一次迭代,要覆盖流式和 webhook 形态的数据源——那些响应不是一次性的 { data: [...] }、而是随时间推移的一连串事件的地方。我们在把它打磨得从 Agent 这一侧看起来像一个异步迭代器,好让提示词的改动降到最小。
如果你今天正在构建一个多平台 Agent,想看看这个封装在实践中是怎么发挥作用的,那就从 unifapi.com/skills 的一个 Skill 起步,或在 unifapi.com/openapi.json 检视 OpenAPI 规范——每一个端点、每一个字段,一个形态。
推荐延伸阅读
MCP 目录工具设计 - 展示 Agent 如何发现返回这个封装的那些操作。
UnifAPI 对比 RapidAPI - 把归一化当作一个对比点。
OpenAPI 规范 - 暴露这些文字背后的实时 schema。