
O stack mínimo viável de agents para Skills de dados públicos

Atualizado
Guia de arquitetura para Skills de dados públicos: cliente do agent, runtime MCP, camada de dados unificada, observabilidade, custos e limites de falha.
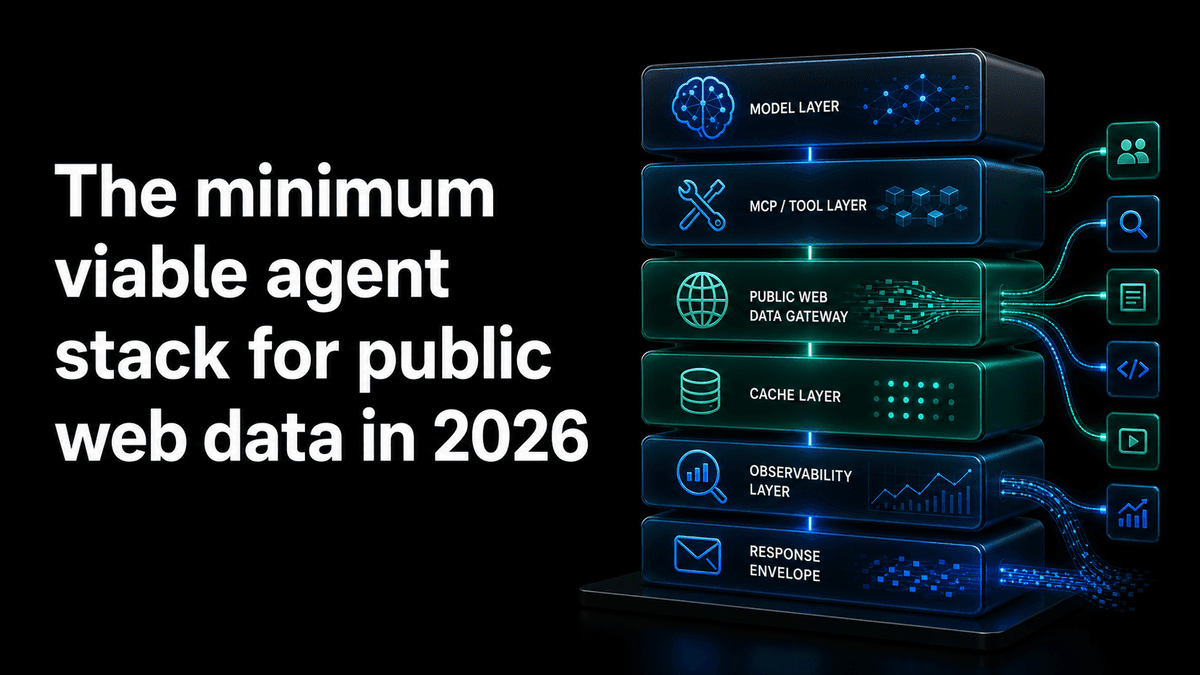
Em resumo: este artigo de arquitetura é o ponto central para equipes que transformam Skills de threads de chat em produtos duráveis: cliente de agent, runtime de MCP, camada de dados públicos e observabilidade.
Construir um fluxo de trabalho em produção que recorre a dados públicos exige quatro peças e algumas salvaguardas: um produto de agent que seja bom em uso de ferramentas, um runtime de MCP, uma camada unificada de dados públicos, observabilidade sobre o que o agent realmente chamou e controles que mantenham custo e escopo inspecionáveis. Tudo além disso precisa conquistar seu lugar.
Este é o stack que manteríamos para Skills de dados públicos como precificação de KOL, descoberta de criadores, social listening, inteligência competitiva e pesquisa de mercado. Ele é intencionalmente menor do que o diagrama de uma plataforma de agents completa, porque a maioria das equipes exagera na primeira versão.
O stack de referência
| Camada | Escolha de desenvolvimento | Escolha de produção | O que ela precisa provar |
|---|---|---|---|
| Produto de agent | Claude, ChatGPT custom MCP apps, OpenClaw, Hermes, Codex, Claude Code, Cursor, VS Code | O runtime de agent em que sua equipe já confia | Consegue chamar ferramentas, inspecionar resultados e revisar a saída |
| Runtime de MCP | URL de MCP hospedada no cliente | Serviço de agent de longa duração com suporte a MCP | Auth estável, descoberta de ferramentas, execução de ferramentas |
| Camada de dados públicos | APIs MCP e HTTP da UnifAPI | A mesma, com escopos e orçamentos explícitos | Um único envelope, um único modelo de cobrança, registros públicos ao vivo |
| Observabilidade | Transcrição do navegador/cliente mais logs | Traces de chamadas de ferramentas, contagem de registros, latência, custo | Consegue reproduzir por que a resposta mudou |
| Persistência | Copie o resultado manualmente | Armazene entradas da execução, IDs de registros, saídas e decisões | Consegue comparar execuções ao longo do tempo |
As quatro primeiras camadas são obrigatórias. A persistência se torna obrigatória assim que o fluxo de trabalho é repetido ou exposto ao cliente. Até lá, o ciclo de aprendizado mais rápido costuma ser uma thread de agent mais um prompt de Skill claro.
Camada 1: o produto de agent
O modelo escolhe as ferramentas; o runtime as executa. Os produtos de agent modernos conseguem lidar com uso de ferramentas em múltiplas etapas sem muita orientação, desde que a tarefa e a superfície de ferramentas sejam claras. Para desenvolvimento, use o produto em que sua equipe já vive: Codex para trabalho nativo no repositório, Claude Code para terminal e automação de projetos, Claude Desktop ou Claude.ai para fluxos de operadores, Cursor quando o trabalho começa no editor.
Não comece construindo uma GUI personalizada a menos que o fluxo de trabalho já tenha entradas estáveis e um comprador recorrente. Uma GUI congela o fluxo de trabalho cedo demais. Uma Skill permite que o operador faça perguntas de acompanhamento, mude o mercado-alvo, peça uma busca mais profunda ou peça ao agent que explique a confiança antes de produtizar qualquer coisa.
Camada 2: runtime de MCP
O MCP é a camada de conexão entre o agent e os sistemas externos. Para Skills de dados públicos, o runtime precisa expor ferramentas, lidar com autenticação OAuth ou bearer, mostrar o status da conexão e permitir que o agent inspecione as operações disponíveis.
Servidores MCP HTTP remotos hoje são o formato padrão para serviços hospedados na nuvem nos principais clientes de agent que verificamos. A referência do Claude Code chama o HTTP de opção recomendada para servidores remotos na nuvem, quando disponível. O Cursor documenta o Streamable HTTP como um transporte remoto com OAuth. A página de Docs MCP da OpenAI mostra o Codex adicionando um servidor MCP Streamable HTTP por URL.
Para a UnifAPI, isso significa que a Skill não deve pedir ao usuário que instale um scraper local ou cole chaves de API de plataformas. Ela deve pedir que ele conecte https://mcp.unifapi.com, autentique com OAuth quando necessário e deixe o agent descobrir as operações através do catálogo de MCP.
Camada 3: camada unificada de dados públicos
A API unificada de dados é o maior ponto de alavancagem deste stack. Se o seu agent acaba chamando um wrapper para o Twitter/X, outro para o Reddit, outro para o YouTube e uma planilha para a precificação de KOL, você construiu um problema de integração multivendor antes mesmo de construir o fluxo de trabalho do agent.
Empurre essa complexidade para trás de um único gateway. O catálogo ao vivo da UnifAPI cobre TikTok, LinkedIn, Instagram, YouTube, Twitter/X, Threads, Reddit e Hacker News por trás de um único servidor MCP e de um único contrato HTTP. O prompt do agent passa a ser "rode a Skill de precificação de KOL" em vez de "chame profile_api, comments_api, search_api, depois costure uma planilha".
O requisito-chave do produto não é apenas a cobertura. É um comportamento de resposta consistente: IDs de requisição previsíveis, um payload de dados, paginação opcional, metadados de cobrança e erros normalizados. São esses detalhes que permitem ao agent se recuperar de uma falha parcial em vez de inventar uma história.
Camada 4: observabilidade e replay
Sem observabilidade, você depura às cegas. O mínimo absoluto para um agent de dados públicos em produção é um trace por execução que registre o prompt do usuário, cada chamada de ferramenta, os argumentos, o status da resposta, a duração, a contagem de registros retornados, a contagem de registros cobrados, a saída do modelo e a decisão final.
Quando você consegue reproduzir uma execução, as regressões deixam de ser misteriosas. Uma execução lenta normalmente é uma de quatro coisas: latência do modelo, latência da fonte pública, um prompt que se ramifica de forma ampla demais ou um loop de retry causado por seleção de operação ambígua. O trace deve dizer qual foi.
| O que registrar | Por que importa |
|---|---|
| Tarefa original do usuário | Explica a intenção e as restrições |
| Operação selecionada | Mostra se a descoberta escolheu a fonte certa |
| Args de query/body | Explica por que uma fonte retornou aqueles registros |
| Contagem de registros e cobrança | Torna o custo previsível |
| Decisões de paginação | Mostra se a execução parou cedo ou tarde demais |
| Confiança e premissas | Mantém a resposta final auditável |
Camada 5: persistência
Não persista tudo no primeiro dia. Persista os fatos mínimos que permitam a um usuário futuro entender ou comparar a decisão. Para uma execução de precificação de KOL, armazene a entrada da campanha, os handles dos criadores, os IDs ou URLs dos registros públicos, as faixas estimadas, a confiança, as premissas e as notas finais. Para social listening, armazene a query, a fonte, a janela de tempo, os principais registros, os temas e um resumo.
A armadilha é salvar a saída bruta da ferramenta sem salvar o contexto da decisão. Um leitor futuro precisa saber por que o agent buscou aqueles registros e o que a resposta deveria ajudar a decidir.
Controles de custo
Agents de dados públicos precisam de controles de custo explícitos, porque o uso de ferramentas pode se ramificar rapidamente. Uma boa Skill define um orçamento padrão de registros, explica quanto custa uma execução leve e pergunta antes de passar da triagem para a pesquisa profunda.
| Controle | Padrão para uma primeira versão |
|---|---|
| Limite de registros | 20-50 registros por fonte antes de pedir para continuar |
| Escopo de plataforma | Comece com a plataforma principal, enriqueça apenas quando necessário |
| Paginação | Pare quando os registros marginais deixarem de mudar a resposta |
| Aprofundamentos | Exija confirmação explícita do usuário para expansão multifonte |
| Saída | Retorne evidências e premissas para que o usuário decida se vale a pena mais dados |
Onde esse stack ainda falha
Primeiro, o OAuth nas próprias contas de SaaS do usuário é uma categoria de integração diferente. Gmail, Linear, Notion, HubSpot e Salesforce são dados privados autorizados pelo usuário. A UnifAPI é para dados públicos. Use uma plataforma de conectores ou um segundo servidor MCP para os sistemas privados do usuário.
Segundo, fluxos de trabalho de longa duração em segundo plano precisam de orquestração fora da thread de chat. Um resumo semanal, um crawl noturno ou um monitoramento por hora devem usar um agendador, uma fila durável e um caminho de notificação. A Skill pode definir o formato da tarefa, mas a entrega em produção precisa de uma camada de execução.
Terceiro, fluxos de trabalho de navegador ainda são necessários quando o próprio site é a interface. Se o agent precisa logar em um portal, preencher um formulário ou navegar por um dashboard, use um stack de browser agent. Se o agent precisa de registros públicos repetíveis, comece pelas APIs.
Uma ordem de construção que mantém você honesto
Comece com uma Skill em um cliente de agent. Adicione o MCP da UnifAPI. Rode cinco tarefas reais manualmente. Inspecione os registros e as saídas finais. Adicione um limite de custo. Adicione logging de traces. Só então produtize o fluxo de trabalho por trás de uma UI de app ou de um job agendado.
A ordem importa porque ela evita infraestrutura prematura. Se a Skill não consegue produzir uma resposta útil em uma thread de agent transparente, uma UI mais bonita não vai consertar isso. Se ela consegue produzir uma resposta útil em uma thread, o caminho para a produtização fica muito mais claro.
Fontes verificadas
Este guia de arquitetura foi atualizado em 2 de junho de 2026 com base na introdução oficial do Model Context Protocol, na página de Docs MCP da OpenAI, na referência de MCP do Claude Code e na documentação de MCP do Cursor.
O que ler em seguida
Design das ferramentas do catálogo de MCP - mergulha na camada de operações do MCP.
Envelope de resposta unificado - cobre o contrato de dados de que o stack depende.
Skills de dados públicos Agent First - conecta a arquitetura de volta às Skills voltadas ao usuário.