推特查看器到处都是,能让 AI 智能体用的几乎没有

更新于
我们像 AI Agent 一样用 curl 测试了 8 个热门 Twitter 查看器。多数会屏蔽脚本或把数据藏在 JavaScript 后面。这里是可用的方案。
一句话总结:推特查看器(Twitter viewer)是一类不用 X 账号就能看公开 X 主页、帖子或热搜榜单的网页。这样的站点有几十个,对用浏览器的人来说大多够用。2026 年 10 月 7 日,我们用
curl、不带 cookie,按 AI 智能体的方式抓取了其中最知名的 8 个。结果是:两个返回 Cloudflare 验证页;两个 Nitter 实例要么宕机,要么因法律原因被封;三个返回不含任何数据的 JavaScript 空壳;只有 FxTwitter 返回了 JSON,却仅限单条帖子和单个用户。没有一个查看器页面本身能被脚本读懂。对智能体友好的推特查看器,应当把请求放进 URL,从同一个 URL 返回 JSON 或 Markdown,在响应头里写明限流,并与计量 API 共用字段名。UnifAPI 的 Twitter 查看器系列就是这么做的,而且每一页都免费使用,无需登录、无需账号、无需 API 密钥,按访客限流:每 10 分钟 20 次查询。
"Twitter viewer" 是围绕 X 搜索量最大的短语之一,而且写法五花八门:中文用户搜"推特查看器""推特在线查看""推特网页查看器",或者干脆就是"看推特";英文有 "x viewer" 和拼错的 "twitter viwer";西语、葡语是 "visualizador de twitter",韩语是 "x 뷰어",日语是 "twitterビューア"。背后的意图只有一个:不登录,也能看到某个账号或某条帖子长什么样。
但敲下这些查询的人变了。越来越多的查询根本不是人敲出来的,而是来自一个被吩咐"查一下这个账号"的智能体,来自一个每晚刷新互动数据的脚本,或者来自一个同时铺开查五十个账号的研究工作流。这些调用方不在乎横幅好不好看,只在乎一件事:页面能不能被程序寻址、读取并信任。本文说的就是这道鸿沟,以及我们在动手做自己的查看器之前测了些什么。
推特查看器是什么,谁在用
推特查看器读取 X 的公开数据,渲染成一个不用账号就能打开的页面。主页查看器显示简介、关注者数量和近期帖子;帖子查看器(也就是常说的推特帖子查看)把一条帖子连同媒体和互动指标完整展示出来;热搜查看器列出某个地区正在流行什么,也就是 X 趋势查询。有些站点把这几样塞进同一个搜索框。
用户分成两半,各有各的需求:
| 调用方 | 对查看器的要求 |
|---|---|
| 用浏览器的人 | 页面快、版面好读、能点链接跳回 X 上的原帖。 |
| 智能体、脚本或模型 | 一个能完整描述请求的 URL、机器可读的响应体、明确的限额。 |
多数查看器只为前一半设计。放在 2022 年这很合理,现在却成了问题:因为复访流量来自后一半,也因为正是后一半能把一个查看器变成整条工作流的数据源。
我们像智能体一样实测了 8 款推特查看器
方法刻意保持简单,因为这正是智能体第一次尝试时会做的事。对每个查看器,我们用 curl、默认 user agent、不带 cookie、不跑 JavaScript,请求 @NASA 的公开主页(或该站能提供的最接近的等价页面)。记录 HTTP 状态码、首个响应里有没有主页数据、是否存在 JSON、Markdown 或 RSS 替代格式,以及站点有没有为智能体写明一条路径。遇到拦截默认 user agent 的站点,我们换成 Chrome 的 user agent 字符串再试一次。
| 查看器 | curl 拿到了什么 | 首个响应含数据 | JSON / Markdown / RSS | 为智能体写明的路径 |
|---|---|---|---|---|
| Nitter (nitter.net) | 无响应 | 否 | RSS,前提是有实例在线 | 无 |
| xcancel.com(Nitter 实例) | HTTP 451,因法律原因不可用,RSS 也一样 | 否 | 否 | 无 |
| Sotwe | HTTP 403,Cloudflare "Just a moment" 验证页 | 否 | 否 | 无 |
| Twstalker | HTTP 403,Cloudflare "Just a moment" 验证页 | 否 | 否 | 无 |
| twitterviewer.net | HTTP 200,一个 5 KB 的 JavaScript 空壳 | 否 | 否;其 llms.txt 明说页面不是 feed | 一个需要 OAuth 2.1 注册的 MCP 服务器 |
| TwitterShots 查看器 | HTTP 200,表单驱动的页面;/twitter-viewer/NASA 404 | 否 | 否 | 有 llms.txt,没有机器端点 |
| Snaplytics | HTTP 200 落地页,查看器重定向到表单 | 否 | 否 | 无 |
| FxTwitter (api.fxtwitter.com) | HTTP 200,JSON | 是 | 单条帖子或单个用户的 JSON | URL 本身;没有限流头,没有搜索和热搜 |
| x.com 本身 | HTTP 200,一个 147 KB 的 JavaScript 应用 | 否 | 否 | 官方 API,需要密钥和套餐 |
有三点很突出。
第一,对自动化而言,Nitter 时代结束了。2024 年 1 月 X 取消访客账号,Nitter 停摆;2025 年它靠真实账号回归;到 2026 年 8 月,项目本身和它最大的几个公共实例收到了 X Corp 的停止侵权函。我们测试当天,最大的实例对所有路径都返回 HTTP 451,RSS 也不例外。建在 Nitter RSS 之上的工作流已经无处可去。
第二,在人工搜索里排名靠前的两个查看器 Sotwe 和 Twstalker,对一切非浏览器客户端都挡着一道 Cloudflare 机器人验证。对只服务真人的网站来说这无可厚非,但智能体拿到的只会是一个 403,外加一页写着 "Just a moment" 的 HTML。
第三,确实考虑到智能体的站点,也只是把这件事放在旁路上。twitterviewer.net 发布了 llms.txt,直言其主页和推文页面是浏览器界面,不是可抓取的 feed,并把智能体指向一个需要 OAuth 注册的 MCP 服务器。FxTwitter 的初衷是修复链接预览,它是唯一对普通 URL 直接回 JSON 的站点,但只覆盖单条帖子和用户记录,不含搜索、回复、媒体墙、热搜或关注者。
所以诚实的结论不是"没有查看器服务智能体",而是"没有查看器用人用的同一个 URL 服务智能体,而那些多少服务了智能体的,只覆盖 X 的一小角"。
推特查看器让智能体碰壁的七种方式
上面那张表只是一个上午的数据,但背后的模式在整个品类里都一致。值得把每种失败方式单独点名,因为每一种的解法都不同。
| # | 失败方式 | 表现 | 为什么会卡住自动化 |
|---|---|---|---|
| 1 | 没有深链 URL | 用户名填进表单;结果页的 URL 和空白页一模一样。 | 智能体无法构造请求,只能驱动浏览器去填表单。 |
| 2 | 只有 HTML | 没有 JSON、Markdown 或纯文本替代格式。 | 模型只能去抓一个从没打算给程序读的版面。 |
| 3 | 由 JavaScript 渲染 | 首字节是空壳;数据靠客户端再发一次请求才到。 | curl 什么也拿不到。无头浏览器既慢又脆弱。 |
| 4 | 机器人拦截墙 | 任何非浏览器客户端都会撞上 CAPTCHA 或 JavaScript 验证。 | 脚本直接被拦;智能体过不了验证。 |
| 5 | 无声限流 | 响应里没有任何地方说明允许多少请求、窗口何时重置。 | 智能体靠被封禁来学习限额,之后也不知道该何时重试。 |
| 6 | 字段名不稳定 | 数字藏在 <span> 标签里,class 名每次改版都在变。 | 今天能跑的解析器下个月就悄悄失效。 |
| 7 | 规模化走进死胡同 | 查看器没有通往字段相同、有文档、可计量的 API 的路径。 | 团队最后只能在一个给人看的页面上搭爬虫。 |
失败方式 1 到 3 解释了为什么 "twitter viewer API" 和 "twitter viewer json" 会成为独立的搜索词。人们找到一个用眼睛看没问题的查看器,然后发现根本没办法调用它。
对智能体友好的推特查看器长什么样
把七种失败方式反过来,就是一份简短的规格。对智能体友好的查看器应当:
- 把请求放进 URL。 主页查看器用
?q=<handle>,帖子查看器用?q=<post URL or ID>。单凭 URL 就能复现这次查看,所以它能被记录、缓存、分享和重试。 - 从同一个 URL 返回机器格式。 给程序用
?format=json,给要把结果当文本读的模型用?format=md或Accept: text/markdown。不是另一个产品,也不是一套注册流程。 - 第一次请求就给数据。 没有空壳,不需要再发一次请求去发现数据。
- 把非浏览器客户端当正常用户。 脚本和浏览器得到同样的答案。滥用控制在网络边缘进行,按流量调校,而不是按客户端类型。
- 说明自己的限额。 每个响应都带
X-RateLimit-Limit、X-RateLimit-Remaining和X-RateLimit-Reset。429 响应带Retry-After,并告诉你在哪里可以解除上限。 - 字段名稳定且有文档。
profile.followers永远是profile.followers。 - 有去处。 当一次查询变成五百次,同样的字段名应当能从一个带密钥的计量 API 拿到,这样代码不用改。
UnifAPI 的免费 X 查看器系列就是这样构建的。每个查看器页面都只是 /tools/x/ 下一个免费端点的薄薄一层,所以浏览器和智能体读到的是完全相同的记录,而这份记录的结构与付费的 X / Twitter API 一致。
智能体最初是怎么找到推特查看器的
智能体的可发现性是另一个独立的问题,和"推特查看器"这个词的排名不是一回事。
当有人让助手"看看 @NASA 最近发了什么",助手通常先去试 https://x.com/NASA,拿到一个没有任何数据的 JavaScript 应用。它的下一步是网页搜索,而它写出的查询和人敲的不一样,更像是问题陈述。根据我们在公开数据上构建和测试智能体的经验,这些查询长这样:
view x profile without login jsonget tweet by url as json no api keyx.com returns empty page curl how to read profiletwitter trends api free no keynitter alternative api 2026fetch twitter replies for a tweet id
能赢下这些查询的页面有几个共同点。它们把 URL 模式原样写进正文,而不是藏在按钮后面;给出 curl 示例和一份响应样例;用上智能体正在扫描的那些词:JSON、Markdown、无需 API 密钥、限流、Retry-After。它们发布 llms.txt,最好还为每个页面提供 Markdown 替代版本,让模型一次请求就能读完整页。它们还会说清工具不做什么,因为知道边界在哪的智能体,就不会在受保护账号上浪费调用。
我们把这些都用在了查看器页面本身。UnifAPI 上的每个 X 查看器都在第一段写明端点、参数和限额,带有 Markdown 替代版本,并列在站点的 llms.txt 里。这么做不是为了钻什么空子,而是在智能体落地的那一页,用智能体的词汇回答智能体的问题。
在命令行里调用推特查看器
系列里的每个查看器都有 URL 形式和端点形式两种用法。两者都免费,都按访客限流,返回同样的响应体。
以 JSON 形式获取一个公开主页:
curl -s "https://unifapi.com/tools/x/profile?handle=nasa" | jq '.profile.followers, .engagementRate'
同一个主页的 Markdown 版本,适合结果直接进模型上下文的场景:
curl -s -H "Accept: text/markdown" "https://unifapi.com/tools/x-profile-viewer?q=nasa"
按 URL 取一条帖子:
curl -s "https://unifapi.com/tools/x/post?url=https://x.com/NASA/status/1234567890123456789"
这条帖子下的回复,按点赞数排序,然后翻到下一页:
curl -s "https://unifapi.com/tools/x/replies?id=1234567890123456789&sort=top"
curl -s "https://unifapi.com/tools/x/replies?id=1234567890123456789&sort=top&cursor=<nextCursor>"
某个地区的实时热搜,Markdown 格式:
curl -s "https://unifapi.com/tools/x/trends?location=japan&format=md"
每个响应都带限流头,所以守规矩的智能体读一下 X-RateLimit-Remaining 就能自己控制节奏,不用瞎猜:
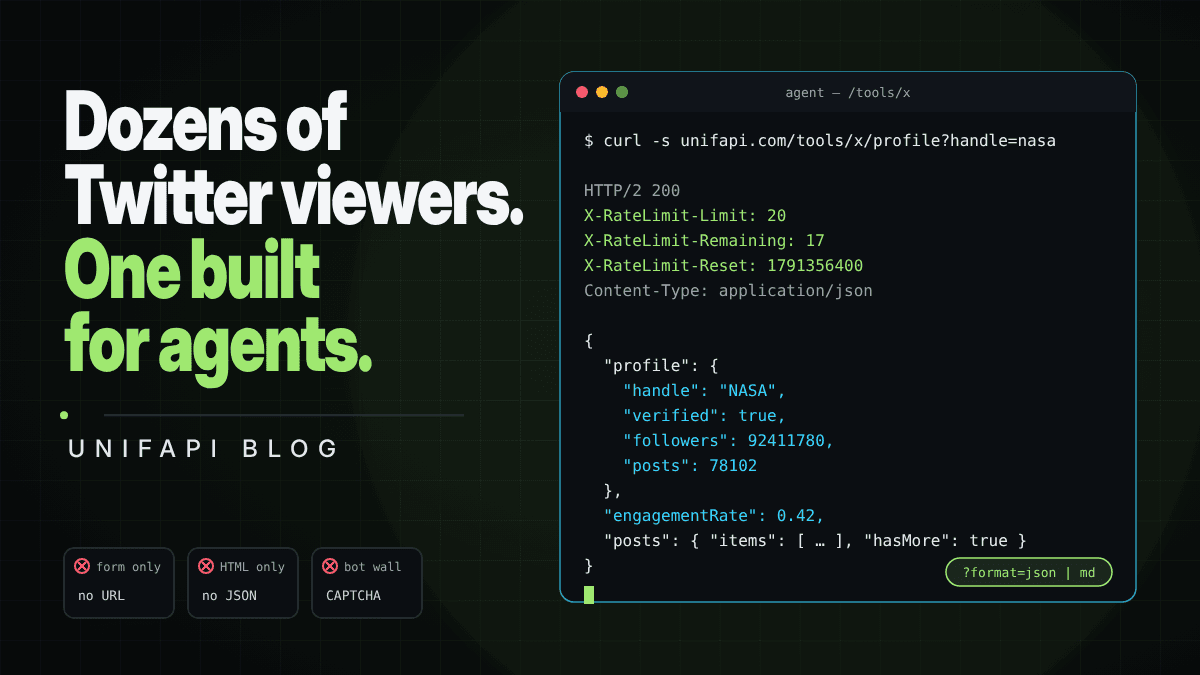
HTTP/2 200
X-RateLimit-Limit: 20
X-RateLimit-Remaining: 17
X-RateLimit-Reset: 1791356400
Content-Type: application/json
窗口用完时,429 的响应体同样是 JSON,并直接给出升级路径,而不是让调用方自己去找:
{
  "error": {
    "type": "rate_limited",
    "message": "Free limit of 20 requests per 10 minutes reached. Retry after 412s, or use a UnifAPI workspace key (pay as you go) for uncapped access.",
    "retryAfterSeconds": 412,
    "upgrade": "https://unifapi.com/apis/twitter"
  }
}
端点参考
九个查看器共用一种信封。列表以 { items, hasMore, nextCursor } 返回,传 cursor=<nextCursor> 翻页。所有错误都是 { error: { type, message } },type 取 validation_error、not_found、rate_limited、upstream_error、upstream_unavailable 之一。
| 端点 | 必填 | 可选 | 返回 |
|---|---|---|---|
/tools/x/profile | handle(或 q、username) | posts(1–10)、cursor | profile、engagementRate、posts 分页 |
/tools/x/post | id(或 url、q) | post,含 author、media、quoted、metrics | |
/tools/x/media | handle | cursor | profile、媒体帖子的 posts 分页 |
/tools/x/replies | id(或 url) | sort=top|recent、cursor | post、replies 分页 |
/tools/x/search | q | cursor | query、posts 分页;支持 X 搜索运算符 |
/tools/x/trends | location(slug 或 WOEID)、woeid | woeid、locationSlug、generatedAt、trends[] | |
/tools/x/communities | q | cursor | query、communities 分页 |
/tools/x/followers | handle | kind=followers|following、cursor | profile、kind、users 分页 |
给任意一个加上 format=md,或发送 Accept: text/markdown,就能拿到同样内容的 Markdown 版本。每个查看器页面都接受同样的参数,形式是 ?q= 加 format=,所以 /tools/x-profile-viewer?q=nasa&format=json 和 /tools/x/profile?handle=nasa 是同一个请求。
完整系列
只用一个查看器很少够用。审核一位创作者,要看主页、媒体页和几条回复线程;追踪一则新闻,要搜索加热搜。这个系列用九个页面覆盖 X 的公开数据面。
| 查看器 | 免费端点 | 读取内容 |
|---|---|---|
| Twitter 查看器 | 转发到其他查看器 | 粘贴任何内容,枢纽页会打开对应的页面。 |
| Twitter 主页查看器 | /tools/x/profile | 横幅、简介、各项计数、近期帖子、互动率。 |
| Twitter 帖子查看器 | /tools/x/post | 一条帖子,含媒体、引用的帖子和全部指标。 |
| Twitter 媒体查看器 | /tools/x/media | 一个账号的照片和视频,以网格展示。 |
| Twitter 回复查看器 | /tools/x/replies | 帖子下的讨论,按热门或最新排序。 |
| Twitter 高级搜索 | /tools/x/search | 匹配查询的帖子,支持 X 的搜索运算符。 |
| X(Twitter)实时热搜榜单 | /tools/x/trends | 十个地区今天在 X 上流行什么。 |
| X 社区查找器 | /tools/x/communities | 按话题查公开社区,附成员数。 |
| Twitter 关注者查看器 | /tools/x/followers | 谁在关注一个账号,以及它关注了谁。 |
枢纽页接受用户名、帖子链接、话题标签或自由文本查询,转发给能回答它的查看器。对智能体来说,这意味着只有一个入口:把输入发到 /tools/twitter-viewer?q=…&format=json,读结果就行。
这些查看器不会做什么
对智能体友好,不等于没有限制,也不等于能看私密内容。
- 只读公开数据。受保护的账号只显示公开的头部信息,别的一概没有。
- 按访客限流:每 10 分钟 20 次查询,在边缘强制执行,并写在响应头里。
- 从不登录 X。不涉及你的任何账号,也不会写入、点赞、关注或发送任何内容。
- 视频从 X 自己的 CDN 播放。不做二次托管,也不提供下载。
- 不能替代 X 的服务条款。像使用任何公开页面一样使用这些记录。
这些边界也正是输出能被放心引用的原因。智能体可以指向一份公开记录,而把接下来做什么的决定权留给操作者。
当查看器不够用的时候
免费查看器是用来看的。一旦工作流需要规模或保障,同样的记录可以通过 UnifAPI 的 X / Twitter API 用工作区密钥获取。定价按量付费,没有需要"长大后离开"的免费层,也没有需要预估规模的订阅,而且字段名与查看器一致,所以针对 /tools/x/profile 写好的提示词,换到 API 上不用重写。
一条典型的路径:
- 有人用 Twitter 主页查看器试了三个账号。
- 智能体拿到同一个 URL 加
?format=json,被要求连夜给五十个账号打分。它撞上了按访客的限额,读到了 429。 - 团队添加一个工作区密钥,把循环挪到 API 上。打分代码一行不改。
这种连续性正是把查看器和 API 建在同一层数据之上的意义。
常见问题
推特查看器是什么? 一个不要求你登录 X,就能显示公开 X 主页、帖子或热搜榜单的网站。它只读账号公开出来的内容。"X viewer""Twitter visualizer""推特在线查看"说的都是同一回事。
不用账号的推特查看器哪个最好? 对人来说,上面那些能打开的站点哪个都行,差别主要在广告和速度。对脚本或 AI 智能体来说,问题就不一样了:要挑一个对普通 URL 直接回 JSON、并写明限流的查看器。在我们测试当天,FxTwitter 对单条帖子和用户做到了这一点,UnifAPI 的查看器则覆盖主页、帖子、回复、媒体、搜索、热搜、社区和关注者。
有还能给脚本用的 Nitter 替代品吗? 没有能直接替换的。Nitter 的公共实例已经宕机或被封,也没有哪个分支沿用同样的路由。要读内容,用一个从 URL 返回 Markdown 或 JSON 的查看器;要订阅 feed,用一个以 JSON 返回同样帖子、并支持 cursor 翻页的 API。
为什么 AI 智能体用不了大多数推特查看器? 多数查看器把请求放在表单而不是 URL 里,只返回 HTML,用 JavaScript 渲染结果,拦截非浏览器客户端,而且从不说明自己的限流。智能体需要的恰恰是每一条的反面。
推特查看器的结果能以 JSON 拿到吗?
在 UnifAPI 的查看器上可以。给任意查看器 URL 加上 format=json,或直接调用对应的 /tools/x/ 端点。要 Markdown 就加 format=md,或发送 Accept: text/markdown。
免费的 X 查看器真的免费吗?限额是多少? 真的。每次查看都是真实查询,不收费。免费查看限每位访客每 10 分钟 20 次,响应头会告诉你还剩多少次、窗口何时重置;不设上限的访问用 UnifAPI 工作区密钥按量付费。
推特查看器会显示私密或受保护的账号吗?用起来安全吗? 不会。受保护的账号只显示公开的头部信息。至于常被问到的 "twitter viewer 安全性":这些查看器只读公开数据,从不登录 X,不涉及你的任何账号,也不会写入、点赞、关注或发送任何内容。
接下来读什么
Twitter 查看器 - 枢纽页;粘贴用户名、链接、话题标签或查询词。
Twitter 主页查看器工作流 - 接洽前审核账号的五分钟检查。
面向公开数据的智能体优先技能 - 如何封装公开数据查询,让智能体无需监督也能使用。
X / Twitter API - 当一次查询变成许多次时的计量接口。