如何用程序读取一条推文的回复

更新于
一个免费端点,以 JSON 或 Markdown 返回任意 X 帖子下的公开回复,可按互动或时间排序,支持游标分页。
一句话总结:
GET https://unifapi.com/tools/x/replies?id=<post id or URL>以 JSON 返回一条帖子及其下的公开回复。它免费使用,无需登录、无需账号、无需 API 密钥,按访客限流。sort=top(默认)按互动排序,sort=recent按时间排序。每页 20 条回复,带nextCursor。每条回复都带作者、正文、指标、媒体和inReplyToPostId,所以可以重建整条线程。这是免费的单帖端点都不提供的那一块 X 数据,也是过去大多数"读一下这条线程"的智能体任务最终都落到无头浏览器上的原因。
帖子下的回复才是反应所在。帖子本身告诉你一个品牌说了什么;回复告诉你人们怎么看、哪里出了问题、他们想要什么,以及哪条抱怨拿到了 4,000 个赞。对情感分析、客户研究和事故监控来说,回复就是数据。
它们也是不用账号时最难读到的那部分 X。FxTwitter 和 vxTwitter 只读单条帖子。syndication 端点只读单条帖子。X 自己的页面是在加载后用 JavaScript 补上回复的,所以 curl 只拿到一个空壳。官方 API 则把回复放在付费层的会话搜索里。
请求
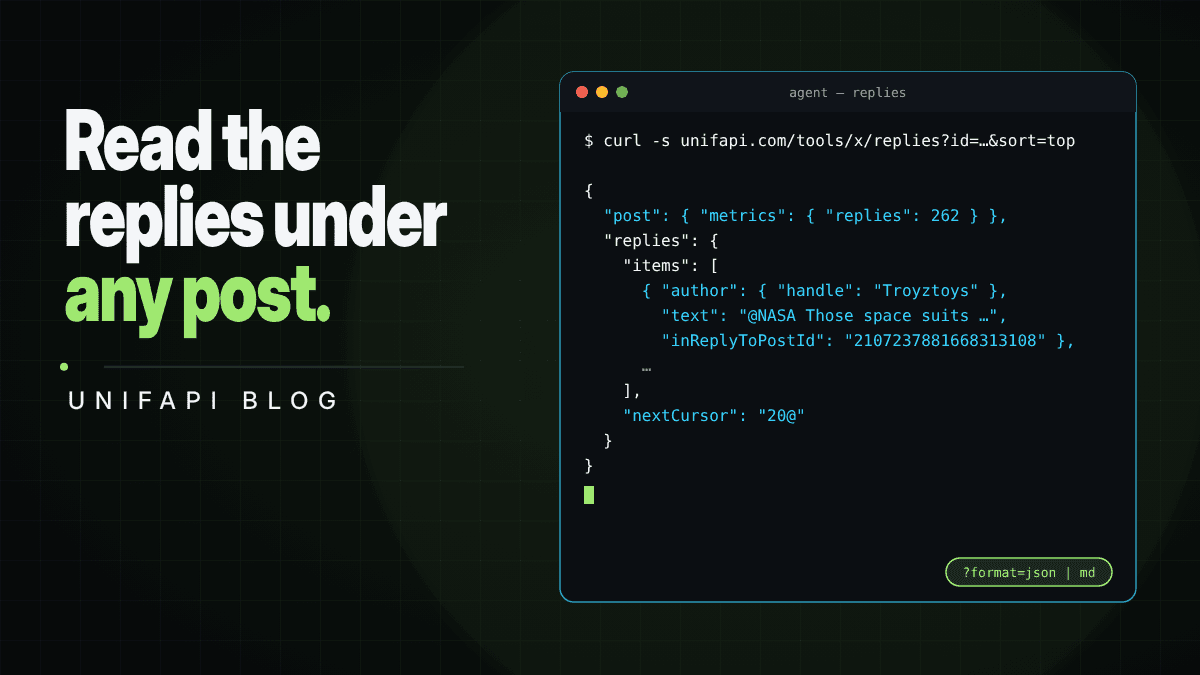
curl -s "https://unifapi.com/tools/x/replies?id=https://x.com/NASA/status/2107237881668313108"
id 接受数字形式的帖子 ID,或完整的 x.com / twitter.com URL。响应:
{
  "post": {
    "id": "2107237881668313108",
    "text": "Time to bring them home 🌎 …",
    "author": { "handle": "NASA", "name": "NASA", "verified": true },
    "metrics": {
      "likes": 7210,
      "reposts": 846,
      "replies": 262,
      "quotes": 60,
      "bookmarks": 197,
      "views": 2823329
    },
    "conversationId": "2107237881668313108"
  },
  "replies": {
    "items": [
      {
        "id": "2107252849688424504",
        "text": "@NASA @Space_Station @SpaceX Those space suits don't look right…",
        "createdAt": "2026-10-05T23:33:22.000Z",
        "author": {
          "handle": "Troyztoys",
          "name": "Tee Crenshaw",
          "verified": true,
          "followers": 1823
        },
        "metrics": {
          "likes": 15,
          "reposts": 1,
          "replies": 0,
          "quotes": 0,
          "bookmarks": 0,
          "views": 894
        },
        "media": [],
        "conversationId": "2107237881668313108",
        "inReplyToPostId": "2107237881668313108"
      }
    ],
    "hasMore": true,
    "nextCursor": "20@"
  }
}
post 是原帖。replies.items 是这场会话里除原帖之外的公开帖子,直接回复和嵌套回复都在内。每条都有 inReplyToPostId,所以回复的回复会指向它的父级,线程可以重建成一棵树。
排序
sort=top(默认)按点赞加转发加回复数排序,大致就是 X 自己的"最相关"标签页的做法。sort=recent 最新在前。想知道"反应如何"用 top;想知道"过去一小时发生了什么"用 recent。
给人看的页面 /tools/x-reply-viewer 把这两个选项做成了切换按钮,而 /tools/x-reply-viewer?q=<id>&sort=recent&format=json 返回的与 API 完全一致。
翻页
回复每页 20 条。把 nextCursor 作为 cursor 传回去即可继续。第一个 cursor 常常长得像 20@,意思是"已取页面的下 20 条";后面的是 X 自己的不透明 cursor。把它们统统当作不透明字符串。
一条有 262 条回复的帖子大约是 14 页。那是你每 10 分钟 20 个免费单位里的 14 个,所以从响应头读 X-RateLimit-Remaining,够用就停;按 top 排序的第一页通常已经包含了真正重要的回复。
一条回复记录包含什么
| 字段 | 含义 |
|---|---|
id、url | 回复的 id 和规范的 x.com URL |
text | 完整正文,开头的 @提及按 X 的存储方式保留 |
createdAt | ISO 8601,UTC |
author | handle、name、verified、followers、avatarUrl…… |
metrics | likes、reposts、replies、quotes、bookmarks、views |
media | 照片和视频,带尺寸和 X CDN 上的 MP4 URL |
inReplyToPostId | 这条回复所回答的帖子 |
conversationId | 会话的根帖子 |
possiblySensitive | X 自己的标记 |
形状与搜索、主页和媒体端点返回的 post 记录相同,所以给帖子打分的函数不用改就能用在回复上。
三样可以做的东西
反应摘要。 取 top 的第一页,把 20 条正文连同原帖喂给模型,让它给出最常见的三种情绪,每种配一条有代表性的引语。二十条回复、一次调用;top 排序已经替你做完了排名。
投诉信息流。 针对一个品牌的公告,每 10 分钟轮询一次 sort=recent,保留两次轮询之间 metrics.likes 越过阈值的回复,把它们转给人工。正在上升的那些,就是会被截图传播的那些。
线程重建。 遍历所有页,建一张从 id 到回复的映射,再把每条回复挂到 inReplyToPostId 上。回复原帖的是第一层;其余嵌套。渲染成 Markdown,你就有了一份可读的会话记录,可以放进报告。
限制
- 只有公开回复。受保护账号的回复和已删除的回复不包含在内,因此原帖上的
replies计数可能高于实际可读的数量。 - 免费限额是每位访客每 10 分钟 20 次查询,所有
/tools/x/*端点共享,一次搜索计为两次。429 响应带Retry-After和解除上限的 URL。 - 大体量、历史数据和保障属于计量 X / Twitter API,用工作区密钥按量付费,字段名相同。
常见问题
不用 Twitter API 能拿到一条推文的回复吗?
能。上面的端点免费读取公开回复,无需登录、无需账号、无需密钥,按访客限流。默认返回 JSON,加 format=md 返回 Markdown。
为什么 X 显示 262 条回复,我只看到 200 条?
有些回复来自受保护账号,有些已被删除,有些被作者隐藏。原帖上的计数是 X 的,可读的集合是公开的那部分。
包含引用帖吗?
不包含。引用是独立的帖子,不是回复。用 /tools/x/search?q=<post url> 搜索该帖子的 URL 可以找到它们。
能把回复读成文本给模型用吗?
能。format=md 把原帖和每条回复渲染成一个 Markdown 区块,含作者、正文、指标和 URL。