不用 X API 密钥,如何把一条推文拿成 JSON

更新于
无需开发者账号、以 JSON 读取单条公开 X 帖子的 5 种实测方法:FxTwitter、vxTwitter、syndication、oEmbed 和 UnifAPI。
一句话总结:读取一条公开帖子的 JSON,并不需要 X 开发者账号。2026 年 10 月 7 日,我们用
curl从五个无需密钥即可响应的地方抓取了同一条 NASA 帖子。FxTwitter 和 vxTwitter 为单条帖子或单个用户返回干净的 JSON 对象。X 自己的 syndication 端点同样以 JSON 返回帖子,但没有文档,随时可能变动。X 的 oEmbed 端点返回的是包在 JSON 里的一段 HTML,不是数据。UnifAPI 的/tools/x/post免费、无需登录、按访客限流,返回帖子及其作者、媒体、引用的帖子和全部指标,字段名与它的搜索、回复和时间线端点一致。如果你永远只需要一条帖子,FxTwitter 就够了。如果这条帖子只是工作流的第一步,后面还要搜索、读回复或遍历时间线,就用一个在所有这些步骤里信封都保持不变的端点。
"如何把推文拿成 JSON"(中文用户搜的往往是"推文 json""推特 api 免费""不用密钥读推文")这个问题,答案已经和 2022 年不一样了。官方 API 仍然能用,但免费层只是一份 token 配额,智能体一个下午就能烧光;付费层则从一笔月费起步,对大多数只需读几条帖子的业余项目来说并不划算。与此同时,围绕嵌入和链接预览这个场景,长出了一批公开端点,它们响应普通 HTTP 请求,不需要任何凭据。
本文就是我们在决定做什么之前跑的那组测试。下面每个请求都可以复现:复制命令运行即可。
测试方法
一条公开帖子 https://x.com/NASA/status/2107237881668313108,用 curl 和默认 User-Agent 抓取,不带 cookie,不带密钥。记录状态码、内容类型,以及响应体里是否以结构化字段的形式包含帖子正文和点赞数。
| 端点 | 状态 | 响应体 | 正文 + 指标为字段 | 媒体 URL | 引用的帖子 | 还能做什么 |
|---|---|---|---|---|---|---|
api.fxtwitter.com/NASA/status/<id> | 200 | JSON,3.3 KB | 是 | 是 | 是 | 单个用户 |
api.vxtwitter.com/NASA/status/<id> | 200 | JSON,1.6 KB | 是 | 是 | 是(URL) | 没有了 |
cdn.syndication.twimg.com/tweet-result?id=<id>&token=x | 200 | JSON,3.2 KB | 仅点赞数和回复数 | 是 | 是 | 没有了 |
publish.twitter.com/oembed?url=… | 200 | 包着 HTML 的 JSON | 否(HTML blockquote) | 否 | 否 | 没有了 |
unifapi.com/tools/x/post?id=<id> | 200 | JSON,与搜索、回复、主页同一模型 | 是 | 是 | 是 | 搜索、回复、媒体、关注者、热搜、社区 |
表里没有一项需要密钥。五个里有三个能给你一份可用的帖子记录。差别在于它们还能做什么、有多稳定,以及任务变大时能否继续沿用同样的字段名。
FxTwitter 和 vxTwitter:为链接预览而生,读取也够用
这两个项目的初衷都是让 X 链接在 Discord 和 Telegram 里能展开预览。它们的 API 是这件事的副产品,而且是个不错的副产品。
curl -s "https://api.fxtwitter.com/NASA/status/2107237881668313108" | jq '.tweet | {text, likes, retweets, views, created_at}'
返回正文,点赞、转发、回复和浏览数,作者对象,带尺寸和 MP4 变体的媒体,引用的帖子,以及一个 created_at 时间戳。vxTwitter 返回一个更扁平的对象,要点相同,另有一个 mediaURLs 数组。
它们不做的事:搜索、帖子下的回复、用户时间线、关注者。用户端点(api.fxtwitter.com/NASA)返回各项计数和简介,但不含帖子。它们还跑在志愿者维护的基础设施上,没有公布的限流,所以一个铺开到几百条帖子的工作流在那里是客人,不是客户。
X 的 syndication 端点:官方、无文档、脆弱
X 通过 cdn.syndication.twimg.com 提供嵌入式时间线。单条帖子的变体会以 JSON 响应:
curl -s "https://cdn.syndication.twimg.com/tweet-result?id=2107237881668313108&token=x" | jq '{text, favorite_count, created_at, user: .user.screen_name}'
这是 X 自家嵌入组件渲染所用的数据,所以准确,但它只带组件会显示的内容:favorite_count 和 conversation_count,没有转发数,没有浏览数。它同样没有文档,token 参数的含义变过不止一次,有些帖子返回的是一个带 tombstone 的存根,而不是正文。把它当交叉校验用,别当依赖。
oEmbed:不是数据
publish.twitter.com/oembed 是 CMS 用来嵌入帖子的端点。它返回 JSON,但载荷是一个把正文装在里面的 HTML blockquote,外加一个 script 标签。没有指标,没有媒体 URL。如果你想要正文,就得从 JSON 里解析 HTML,这是两头的坏处都占全了。
UnifAPI 的免费帖子端点
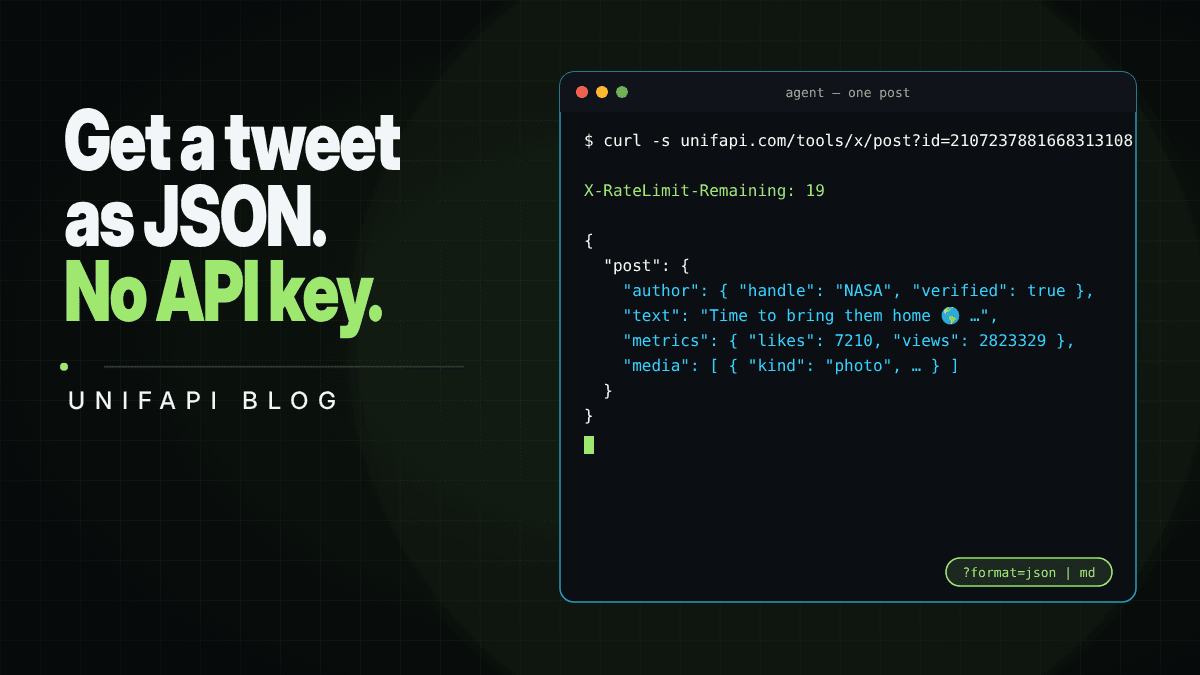
curl -s "https://unifapi.com/tools/x/post?id=2107237881668313108"
{
  "post": {
    "id": "2107237881668313108",
    "text": "Time to bring them home 🌎\n\nAfter nearly eight months aboard the @Space_Station, the four members of Crew-12 will soon head back to Earth…",
    "createdAt": "2026-10-05T22:33:56.000Z",
    "language": "en",
    "url": "https://x.com/NASA/status/2107237881668313108",
    "author": {
      "id": "11348282",
      "handle": "NASA",
      "name": "NASA",
      "verified": true,
      "followers": 92373840
    },
    "metrics": {
      "likes": 7210,
      "reposts": 846,
      "replies": 262,
      "quotes": 60,
      "bookmarks": 197,
      "views": 2823329
    },
    "media": [
      {
        "kind": "photo",
        "url": "https://pbs.twimg.com/media/HT5pcNwXwAAKdoM.jpg",
        "width": 2048,
        "height": 1365
      }
    ],
    "quoted": null
  }
}
id 参数也接受完整的 x.com 或 twitter.com 状态 URL,所以智能体可以把用户粘贴的任何东西原样传过去。加上 format=md 或发送 Accept: text/markdown,就能拿到同一条帖子的 Markdown 版本,放进模型上下文比 JSON 更省。
对智能体而言,有三个特性很重要:
- 信封是共享的。
post、author、metrics和media在/tools/x/search、/tools/x/replies、/tools/x/profile和/tools/x/media上形状完全相同。在其中一个上读.metrics.likes的提示词,在所有端点上都能用。 - 限额写在响应里。 每个响应都带
X-RateLimit-Limit、X-RateLimit-Remaining和X-RateLimit-Reset。免费限额是每位访客每 10 分钟 20 次查询,一次搜索计为两次;429 响应包含Retry-After,以及解除上限的 URL(计量的 X / Twitter API,按量付费,无需订阅)。 - 错误带类型。 id 缺失或格式错误是
{ "error": { "type": "validation_error", … } },帖子已删除是not_found。智能体可以直接按error.type分支,不用解析提示文字。
每个端点的完整参数表和一份抓取的响应样例,都在各工具的 Markdown 页面上,例如 /tools/x-post-viewer/index.md,以及 /llms.txt。
该用哪个
- 一条帖子,用在展开链接预览的机器人里:FxTwitter。这正是它的本职。
- 交叉核对一条帖子的正文是否与 X 提供的一致:syndication 端点。
- 帖子只是更大任务的第一步(读它,再读它的回复,再搜索反应,再看谁回复了):UnifAPI 的免费端点,因为后面的步骤都存在,而且形状相同。
- 大体量、超出近期窗口的历史数据,或者保障:带工作区密钥的计量 API。字段名与免费端点一致,所以提示词不用改。
常见问题
读一条公开推文需要 Twitter 开发者账号吗?
不需要。本文的五个端点都不需要。官方 API 是在写入、读取私密数据和需要保障吞吐量时才用得上的。
直接抓取 x.com 可行吗?
用 curl 不行。x.com/NASA/status/<id> 返回一个 147 KB 的 HTML 空壳;帖子是页面加载后由 JavaScript 渲染的。你得用无头浏览器,更慢、更贵,而且标记一变就坏。
UnifAPI 端点能读受保护账号的帖子吗?
不能。受保护和已删除的帖子返回 not_found。这些端点只读公开数据,从不绕过 X 的隐私设置。
免费限额是多少?
每位访客每 10 分钟 20 次查询,所有 /tools/x/* 端点共享(一次搜索计为两次),并写在响应头里。使用这些端点免费,无需登录、无需账号;解除限额靠 UnifAPI 工作区密钥按量付费;没有需要申请的免费密钥层。