一个返回 JSON、支持 X 搜索运算符的免费 Twitter 搜索 API

更新于
无需 API 密钥,从脚本或 AI Agent 以 JSON 搜索近期公开 X 帖子:端点、可用的搜索运算符、游标分页和限制。
一句话总结:
GET https://unifapi.com/tools/x/search?q=<query>以 JSON 返回匹配查询的公开 X 帖子。它免费使用,无需登录、无需账号、无需 API 密钥,按访客限流。X 的搜索运算符在q里都能用:from:、to:、since:、until:、min_faves:、min_retweets:、filter:media、filter:links、-filter:replies、lang:和带引号的短语。结果每页 20 条,最新在前,带nextCursor翻页。免费限额是每位访客每 10 分钟 20 个单位,写在X-RateLimit-*响应头里;一次搜索计 2 个单位,因为它是上游开销最大的调用,所以相当于 10 次搜索。不加日期时拿到的是最新的帖子;加上since:和until:,同一个搜索可以回溯到 2006 年。
人们想不用账号从 X 拿到的东西里,搜索是唯一没有好的免费答案的那一个。链接预览 API(FxTwitter、vxTwitter)只读单条帖子。syndication 端点只读单条帖子。Nitter 有搜索,但大多数公共 Nitter 实例已经消失或因法律原因被封。剩下的选择要么是带付费层的开发者账号,要么是用无头浏览器驱动 x.com/search,又慢又脆弱,还违反服务条款。
本文说的是这个免费搜索端点能做什么、怎么查询,以及它的边界在哪。
请求
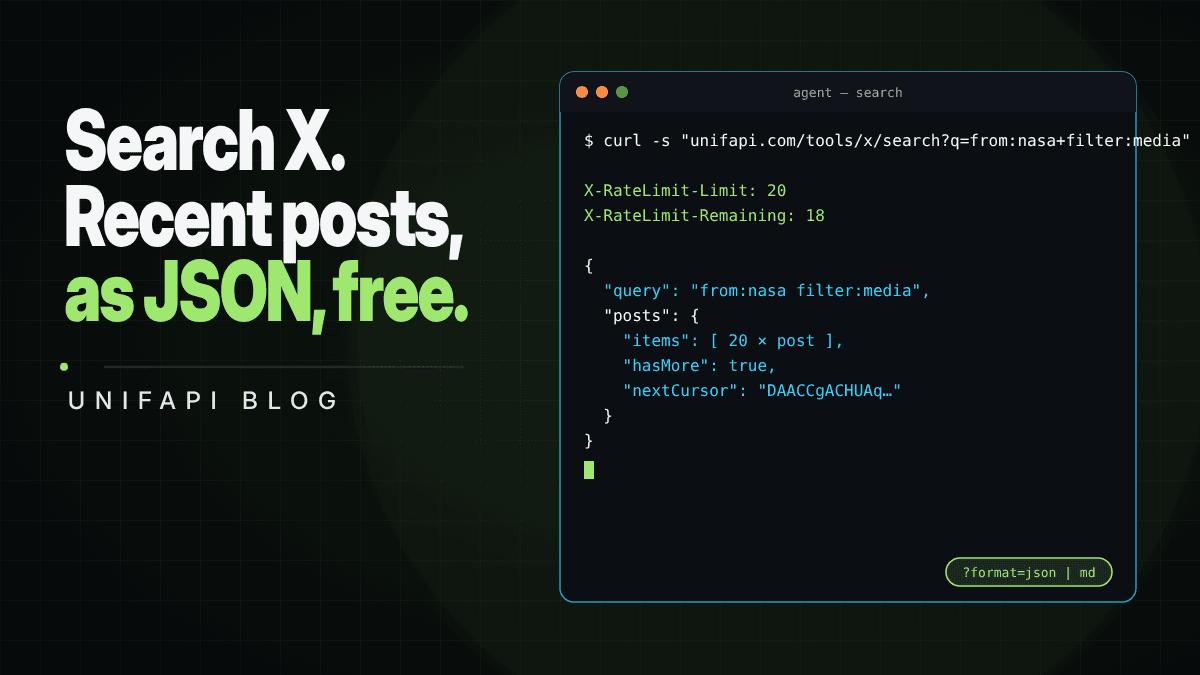
curl -s "https://unifapi.com/tools/x/search?q=from%3Anasa%20filter%3Amedia"
{
  "query": "from:nasa filter:media",
  "posts": {
    "items": [
      {
        "id": "2107566197579341846",
        "text": "After delivering science and supplies to the @Space_Station earlier this year, Northrop Grumman's Cygnus XL cargo spacecraft is scheduled to depart on Friday…",
        "createdAt": "2026-10-06T20:18:32.000Z",
        "url": "https://x.com/NASA/status/2107566197579341846",
        "author": { "handle": "NASA", "name": "NASA", "verified": true, "followers": 92373839 },
        "metrics": {
          "likes": 2195,
          "reposts": 302,
          "replies": 114,
          "quotes": 20,
          "bookmarks": 104,
          "views": 1520159
        },
        "media": [
          {
            "kind": "photo",
            "url": "https://pbs.twimg.com/media/…jpg",
            "width": 1920,
            "height": 1280
          }
        ]
      }
    ],
    "hasMore": true,
    "nextCursor": "DAACCgACHUAq4qFAJxAKAAMd…"
  }
}
同一个请求在给人看的页面上是 https://unifapi.com/tools/x-search?q=from:nasa filter:media,给这个页面 URL 加上 &format=json 就返回上面的 JSON。换成 format=md,或发送 Accept: text/markdown,则以 Markdown 返回帖子,比 JSON 更适合塞进模型的上下文窗口。
可用的运算符
查询会原样传给 X 的搜索,所以 X 为自家搜索框写明的运算符在这里都能用。下面是我们最常用的几个:
| 运算符 | 示例 | 作用 |
|---|---|---|
from: | from:nasa | 某个账号发的帖子 |
to: | to:nasa | 回复给某个账号的帖子 |
@handle | @nasa | 提及某个账号的帖子 |
#tag | #Formula1 | 带某个话题标签的帖子 |
"phrase" | "crew-12" | 精确短语 |
since: / until: | since:2026-10-01 | 日期范围(按整天) |
min_faves: | min_faves:100 | 至少 N 个赞 |
min_retweets: | min_retweets:50 | 至少 N 次转发 |
filter:media | from:nasa filter:media | 只要带照片或视频的帖子 |
filter:links | filter:links | 只要带链接的帖子 |
-filter:replies | #Formula1 -filter:replies | 排除回复 |
-filter:retweets | from:nasa -filter:retweets | 排除转发 |
lang: | lang:ja | 语言代码 |
OR | nasa OR esa | 任一词 |
它们可以组合。"NASA 最近一周发的、至少 100 个赞、带照片、不含回复的帖子"写成:
from:nasa since:2026-09-30 min_faves:100 filter:media -filter:replies
Twitter 高级搜索页面为其中最常用的五个(账号、日期、点赞、媒体、回复)各提供一个筛选项,并显示它们拼出的查询,那正是 API 收到的同一个字符串。
最新,而非热门
X 的搜索有两种排序:"热门"(Top)混合相关性和时间,会毫不犹豫地把一条 2009 年的帖子排在最前;"最新"(Latest)严格按时间倒序。免费端点请求的是"最新"。对于监控、对某个事件的反应,以及任何带 since: 边界的查询,这正是你想要的。如果你要的是"本周关于某话题点赞最多的帖子",就自己按 metrics.likes 给"最新"结果排序,或者加上 min_faves: 砍掉长尾。
翻页
免费 API 里每个列表都是 { items, hasMore, nextCursor }。要继续,把 cursor 传回去:
curl -s "https://unifapi.com/tools/x/search?q=%23Formula1&cursor=DAACCgACHUAq4qFAJxAKAAMd…"
cursor 是不透明字符串,不要解析。hasMore 为 true 当且仅当 nextCursor 有值。一页搜索是 20 条帖子,所以三次请求大约读到 60 条,花掉你 20 个单位里的 6 个。
限额,就在响应里
HTTP/2 200
X-RateLimit-Limit: 20
X-RateLimit-Remaining: 16
X-RateLimit-Reset: 1791357984
免费层是每位访客每 10 分钟 20 个单位,所有 /tools/x/* 端点共享,一次搜索计 2 个。用完时,回答是一个带 Retry-After 的 429,响应体是 JSON,写明到哪里解除上限:
{
  "error": {
    "type": "rate_limited",
    "message": "Free limit of 20 requests per 10 minutes reached. Retry after 412s, or use a UnifAPI workspace key (pay as you go) for uncapped access.",
    "retryAfterSeconds": 412,
    "upgrade": "https://unifapi.com/apis/twitter"
  }
}
守规矩的智能体会在决定翻页之前先读 X-RateLimit-Remaining,并按 Retry-After 休眠,而不是循环重试。
它不做什么
- 相关性。 结果只按从新到旧排列。旧帖子可以用日期找到(
from:jack until:2006-04-01返回 2006 年 3 月的帖子),但没有什么会把一段时间里最好的帖子排在前面,而且 X 按它自己的时区划分since:/until:的日期边界,所以一个日期范围前后可能各多出几个小时。 - 受保护账号。 只返回公开帖子。
- 计数。 没有"共匹配多少条帖子"的数字;X 的搜索不提供这个。
- 保障。 免费层是共享基础设施,按访客设上限。需要大体量或 SLA 的工作流应转到计量 API,那里字段名相同。
二十行写一个监控循环
import requests, time

BASE = "https://unifapi.com/tools/x/search"
seen = set()

def poll(query):
    r = requests.get(BASE, params={"q": query}, headers={"Accept": "application/json"})
    if r.status_code == 429:
        time.sleep(int(r.headers.get("Retry-After", "60")))
        return []
    r.raise_for_status()
    fresh = [p for p in r.json()["posts"]["items"] if p["id"] not in seen]
    seen.update(p["id"] for p in fresh)
    return fresh

while True:
    for post in poll('"unifapi" -filter:replies'):
        print(post["createdAt"], post["author"]["handle"], post["metrics"]["likes"], post["url"])
    time.sleep(600)
每 10 分钟一次搜索是 20 个免费单位里的 2 个;这个循环永远不会触到限额,但它照样处理了 429 的情况。
常见问题
2026 年还有免费的 Twitter 搜索 API 吗?
有,就是这个:免费使用,无需登录、无需 API 密钥,按访客限流,每 10 分钟最多搜索 10 次。官方 X API 没有免费的搜索层,它的免费套餐只允许发帖。
Twitter 高级搜索运算符能用吗?
能。查询原样传给 X 的搜索,所以 from:、since:、until:、min_faves:、filter:media、-filter:replies、lang: 和带引号的短语都能用。
搜索能回溯多久?
可以回溯到 2006 年。不加日期时先拿到最新的帖子;加上 since: 和 until: 就能跳到某个时间段,例如 from:jack until:2006-04-01。
能以 Markdown 而不是 JSON 拿结果吗?
能。加上 format=md 或发送 Accept: text/markdown。Markdown 渲染会逐条列出帖子的作者、正文、指标和 URL。