
公開データのSkills を支える実用最小限のエージェントスタック

更新日
公開データのSkills のための実践的なアーキテクチャガイド:エージェントクライアント、MCPランタイム、統合データレイヤー、可観測性、コスト管理、そして失敗の境界線。
要点:本アーキテクチャ解説は、チャットスレッド上のSkills を耐久性のあるプロダクトへと育てるチームのための基盤となる記事です。エージェントクライアント、MCPランタイム、公開データレイヤー、そして可観測性を扱います。
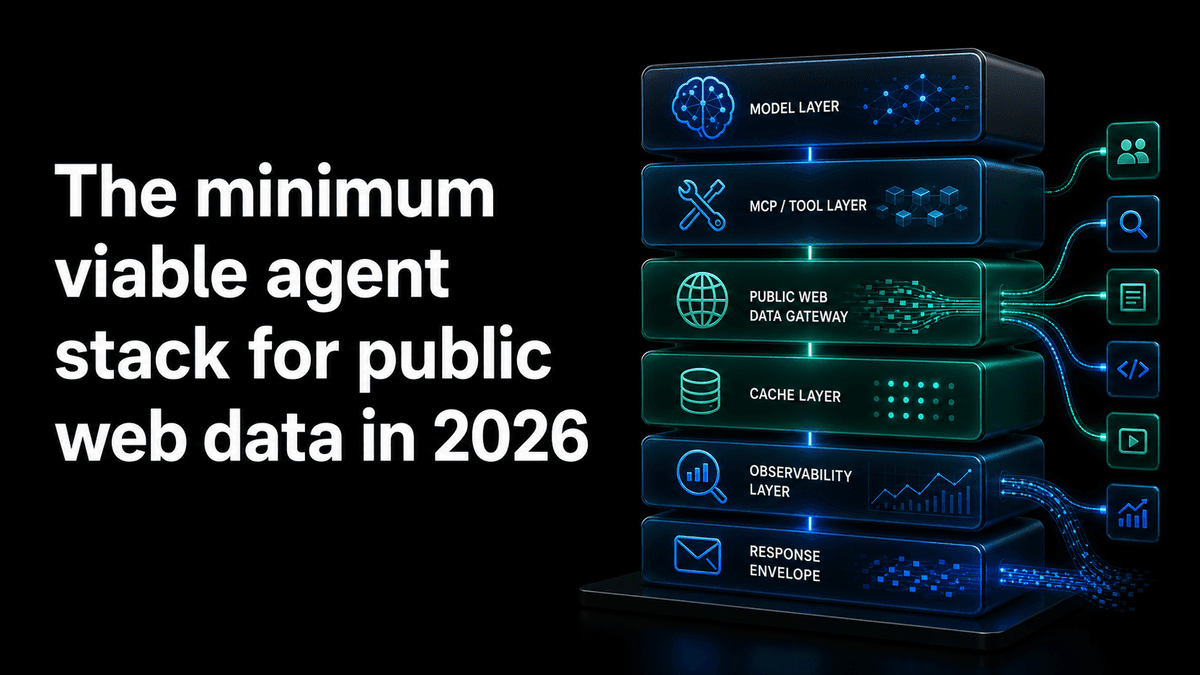
公開データを取りに行く本番ワークフローを構築するには、4つの構成要素といくつかのガードレールが必要です。ツール利用に長けたエージェントプロダクト、MCPランタイム、統合された公開データレイヤー、エージェントが実際に何を呼び出したかを把握する可観測性、そしてコストとスコープを検査可能に保つ管理機構です。それ以外のものは、その存在意義を自ら証明できて初めて加える価値があります。
これは、KOLの価格算出、クリエイター発見、ソーシャルリスニング、競合インテリジェンス、市場調査といった公開データのSkills のために、私たちが残しておくスタックです。完全なエージェントプラットフォームの構成図よりも意図的に小さく設計しています。なぜなら、ほとんどのチームは最初のバージョンを作り込みすぎてしまうからです。
リファレンススタック
| レイヤー | 開発時の選択肢 | 本番運用の選択肢 | それが証明すべきこと |
|---|---|---|---|
| エージェントプロダクト | Claude、ChatGPT のカスタムMCPアプリ、OpenClaw、Hermes、Codex、Claude Code、Cursor、VS Code | チームがすでに信頼しているエージェントランタイム | ツールを呼び出し、結果を検査し、出力を修正できること |
| MCPランタイム | クライアント内でホスト型のMCP URL を使用 | 長時間稼働するMCP対応のエージェントサービス | 安定した認証、ツール発見、ツール実行 |
| 公開データレイヤー | UnifAPI のMCP とHTTP API | 同上、ただし明示的なスコープと予算を伴う | 1つのエンベロープ、1つの課金モデル、ライブな公開記録 |
| 可観測性 | ブラウザ/クライアントのトランスクリプトとログ | ツール呼び出しトレース、レコード数、レイテンシ、コスト | 回答が変わった理由を再生できること |
| 永続化 | 結果を手動でコピーする | 実行の入力、レコードID、出力、判断を保存する | 複数回の実行を時系列で比較できること |
最初の4つのレイヤーは必須です。永続化は、ワークフローを繰り返すようになったり、顧客向けになったりした時点で必須になります。それまでは、最速の学習ループはたいていエージェントスレッドと明快なSkill プロンプトの組み合わせです。
レイヤー1:エージェントプロダクト
モデルがツールを選び、ランタイムがそれを実行します。最新のエージェントプロダクトは、タスクとツールの表面が明確であれば、ほとんどプロンプトを書かなくても複数ステップのツール利用をこなせます。開発時には、チームがすでに日常的に使っているプロダクトを使いましょう。リポジトリに密着した作業ならCodex、ターミナルやプロジェクトの自動化ならClaude Code、オペレーター向けのワークフローならClaude Desktop やClaude.ai、作業がエディタから始まるならCursor、といった具合です。
ワークフローの入力がすでに安定していて、繰り返し購入するバイヤーが存在するのでない限り、カスタムGUIの構築から始めてはいけません。GUIはワークフローを早すぎる段階で固定してしまいます。Skill であれば、何かをプロダクト化する前に、オペレーターが追加の質問をしたり、対象市場を変えたり、より深い検索を要求したり、エージェントに確信度を説明させたりできます。
レイヤー2:MCPランタイム
MCPは、エージェントと外部システムをつなぐ接続レイヤーです。公開データのSkills では、ランタイムがツールを公開し、OAuth またはベアラー認証を処理し、接続状態を表示し、エージェントが利用可能な操作を検査できるようにする必要があります。
私たちが確認した主要なエージェントクライアントでは、リモートHTTP MCPサーバーが、クラウドホスト型サービスの標準的な形になっています。Claude Code のリファレンスは、利用可能な場合のリモートクラウドサーバーにおいて、HTTP を推奨オプションと位置づけています。Cursor はOAuth を伴うリモートトランスポートとしてStreamable HTTP を文書化しています。OpenAI のドキュメントのMCPページでは、Codex がURLでStreamable HTTP MCPサーバーを追加する様子が示されています。
UnifAPI の場合、これはSkill がユーザーにローカルのスクレイパーをインストールさせたり、プラットフォームのAPIキーを貼り付けさせたりすべきではない、ということを意味します。Skill がユーザーにお願いすべきは、https://mcp.unifapi.com に接続し、必要に応じてOAuth で認証し、エージェントにMCPカタログを通じて操作を発見させることです。
レイヤー3:統合された公開データレイヤー
統合データAPIは、このスタックの中で最大のレバレッジポイントです。もしあなたのエージェントが、Twitter/X 用に1つのラッパー、Reddit 用に別のラッパー、YouTube 用にさらに別のラッパー、そしてKOLの価格算出にスプレッドシートを呼び出すことになってしまったら、エージェントのワークフローを作る前に、すでにマルチベンダー連携という問題を作り上げてしまっています。
その複雑さは1つのゲートウェイの裏に押し込みましょう。UnifAPI のライブカタログは、TikTok、LinkedIn、Instagram、YouTube、Twitter/X、Threads、Reddit、Hacker News を、1つのMCPサーバーと1つのHTTP契約の裏でカバーします。エージェントへのプロンプトは「profile_api、comments_api、search_api を呼び出してからスプレッドシートを組み立てて」ではなく、「KOL価格算出のSkill を実行して」になります。
ここで重要なプロダクト要件は、単なるカバレッジではありません。一貫したレスポンスの挙動です。予測可能なリクエストID、データペイロード、オプションのページネーション、課金メタデータ、そして正規化されたエラー。これらの細部こそが、部分的な失敗の際にエージェントが作り話をするのではなく、回復することを可能にします。
レイヤー4:可観測性と再生
可観測性がなければ、手探りでデバッグすることになります。本番運用の公開データエージェントに必要な最低限は、実行ごとのトレースです。ユーザーのプロンプト、すべてのツール呼び出し、引数、レスポンスのステータス、所要時間、返ってきたレコード数、課金されたレコード数、モデルの出力、そして最終的な判断を記録します。
実行を再生できるようになれば、回帰(リグレッション)はもう謎ではなくなります。実行が遅い場合、その原因はたいてい次の4つのいずれかです。モデルのレイテンシ、公開ソースのレイテンシ、対象を広げすぎたプロンプト、または操作選択の曖昧さによって引き起こされたリトライループ。トレースは、それがどれだったのかを教えてくれるはずです。
| 記録すべきこと | なぜ重要か |
|---|---|
| 元のユーザータスク | 意図と制約を説明する |
| 選択された操作 | 発見が正しいソースを選んだかどうかを示す |
| クエリ/ボディの引数 | あるソースがそれらのレコードを返した理由を説明する |
| レコード数と課金 | コストを予測可能にする |
| ページネーションの判断 | 実行が早すぎ/遅すぎで止まったかどうかを示す |
| 確信度と前提 | 最終的な回答を監査可能に保つ |
レイヤー5:永続化
初日からすべてを永続化してはいけません。将来のユーザーがその判断を理解したり比較したりできる、最小限の事実だけを永続化しましょう。KOL価格算出の実行であれば、キャンペーンの入力、クリエイターのハンドル、公開記録のIDやURL、推定レンジ、確信度、前提、そして最終的なメモを保存します。ソーシャルリスニングであれば、クエリ、ソース、対象期間、上位レコード、テーマ、そして要約を保存します。
罠は、判断のコンテキストを保存せずに生のツール出力だけを保存することです。将来の読み手は、エージェントがなぜそれらのレコードを取得したのか、そしてその回答が何の判断を助けるはずだったのかを知る必要があります。
コスト管理
公開データエージェントには明示的なコスト管理が必要です。なぜなら、ツール利用は一気に広がりうるからです。優れたSkill は、デフォルトのレコード予算を設定し、軽い実行にどれくらいのコストがかかるかを説明し、スクリーニングから深掘りリサーチへ移る前に確認を取ります。
| 管理項目 | 最初のバージョンでのデフォルト |
|---|---|
| レコード上限 | 続行を尋ねる前は、ソースごとに20〜50件 |
| プラットフォーム範囲 | 主要プラットフォームから始め、必要なときだけ拡充する |
| ページネーション | 限界レコードが回答を変えなくなったら止める |
| 深掘り | マルチソースへの拡大には明示的なユーザー確認を必須とする |
| 出力 | 証拠と前提を返し、追加データに価値があるかをユーザーが判断できるようにする |
このスタックでもなお失敗するところ
第一に、ユーザー自身のSaaSアカウントへのOAuth は、まったく別の連携カテゴリです。Gmail、Linear、Notion、HubSpot、Salesforce は、ユーザーが認可するプライベートデータです。UnifAPI は公開データのためのものです。ユーザーのプライベートシステムには、コネクタープラットフォームか2つ目のMCPサーバーを使いましょう。
第二に、長時間稼働するバックグラウンドワークフローには、チャットスレッドの外側でのオーケストレーションが必要です。週次ダイジェスト、夜間クロール、毎時モニターには、スケジューラー、耐久性のあるキュー、通知経路を使うべきです。Skill はタスクの形を定義できますが、本番運用での配信には実行レイヤーが必要です。
第三に、ウェブサイトそのものがインターフェースである場合には、依然としてブラウザワークフローが必要です。エージェントがポータルにログインしたり、フォームに入力したり、ダッシュボードを操作したりしなければならないなら、ブラウザエージェントのスタックを使いましょう。エージェントが繰り返し取得可能な公開記録を必要とするなら、APIから始めましょう。
あなたを誠実に保つ構築順序
1つのエージェントクライアントで1つのSkill から始めましょう。UnifAPI のMCP を追加します。実際のタスクを5つ、手作業で実行します。レコードと最終出力を検査します。コスト上限を追加します。トレースのロギングを追加します。それらが済んで初めて、ワークフローをアプリのUIやスケジュールジョブの裏でプロダクト化します。
この順序が重要なのは、早すぎるインフラ整備を防ぐからです。透明なエージェントスレッドの中でSkill が有用な回答を生み出せないなら、見栄えのよいUIがそれを直すことはありません。スレッドの中で有用な回答を生み出せるなら、プロダクト化への道筋はずっと明確になります。
確認したソース
本アーキテクチャガイドは、2026年6月2日に、公式の Model Context Protocol の概要、OpenAI ドキュメントのMCPページ、Claude Code のMCPリファレンス、そしてCursor の MCPドキュメント に照らして更新されました。
次に読むべきもの
MCPカタログのツール設計 - MCPの操作レイヤーを掘り下げます。
統合レスポンスエンベロープ - このスタックが依存するデータ契約を扱います。
Agent First な公開データのSkills - アーキテクチャをユーザー向けのSkills へと結び戻します。