
なぜ公開データのSkills には統合レスポンスエンベロープが必要なのか

更新日
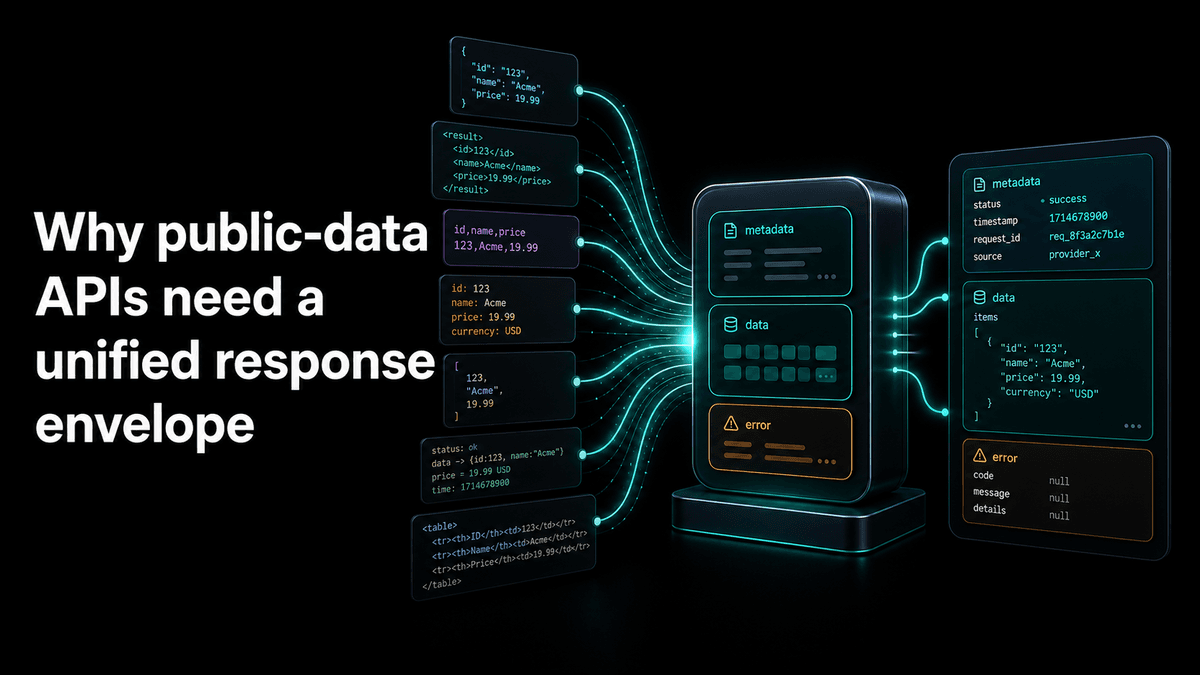
プラットフォームごとにレスポンス形式は異なります。UnifAPI は 1 つのエンベロープにまとめ、Skills が確実に呼び出し・比較・復旧できるようにします。
要点:これはレスポンス契約に関する記事です。公開プラットフォームは異なりますが、エージェントにはページネーション、課金、エラー、レコードのための1つのエンベロープが必要です。
すべての公開データソースは、異なるレスポンスの形を返します。TikTok は結果をある方法でラップし、Reddit は別の方法で、YouTube はまた別の方法で、LinkedIn はさらに別の方法でラップします。あなたのエージェントがそれらすべてと直接やり取りすれば、そのばらつきのすべてを引き継ぐことになります。ページネーションのロジックが分岐し、リトライポリシーが分岐し、エラーのパースが分岐します。私たちはこれを、すべての操作を1つのエンベロープに通すことで解決します。これがそのスキーマであり、なぜそれが重要なのかです。
問題
ソースのばらつきは、マルチプラットフォームのエージェントにかかる見えない税金です。エージェントのツール利用ループは多数の形を扱わなければならず、その複雑さは、維持にコストのかかる3か所に現れます。プロンプト(モデルが各形を教え込まれなければならない)、リトライポリシー(失敗後にソースごとにページネーションの仕方が異なる)、そしてエラーエンベロープ(あるプラットフォームのunauthorizedレスポンスは別のものとはまったく似ていない)です。
私たちは、自分たちのデモエージェントがトークンの大半を推論ではなく形の手品に費やすのを目にし、正しい修正はエージェントではなくゲートウェイにあると判断しました。
UnifAPI のエンベロープ
私たちが公開するすべてのHTTPエンドポイントは、あらゆるプラットフォーム横断で、同じ外側の形を返します。{ request_id, data, pagination?, billing } です。data の内側のフィールドはプラットフォーム固有です。TikTok の動画にはハッシュタグがあり、Reddit の投稿にはサブレディットがありますが、その周りのものはすべて一貫しています。
エラーは閉じた語彙へと畳み込まれます。それぞれが人間可読なメッセージと機械可読なタイプを持ちます。モデルは、プラットフォーム固有のテキストを認識しなくても、タイプに基づいて分岐できます。
私たちが使うリシェイプのパターン
公開プラットフォームを1つのエンベロープの裏に標準化するということは、私たちのリシェイプレイヤーがプラットフォームあたり数百行になるということです。3つのパターンが大半を占めます。
カーソルの統一 — すべてのプラットフォームのページネーショントークン(max_cursor、after、nextPageToken、end_cursor、page)は pagination.cursor になります。私たちは、ソースが提供するどんなシグナルからでも has_more を計算します(length === limit、明示的な has_more フラグ、null の next-cursor など)。
フィールドのフラット化 — ソースがデータを3階層深くネストするとき(data.data.children.data、Reddit、あなたのことです)、私たちはそれをトップレベルの data[] へと引き上げます。モデルは中間のエンベロープを決して見ず、レコードだけを見ます。
防御的なパース — 公開プラットフォームは通知なしにフィールドの型を変えます(カウントが文字列になる、配列が単一の項目になる、タイムスタンプが null になる)。リシェイプレイヤーは各フィールドを宣言された型へと強制変換し、必須フィールドが欠けている場合にのみそのレコードを破棄します。その規律が、生の素通しで私たちが見た静かな失敗のほとんどを捕らえます。
これを省くと何が壊れるか
エンベロープがないと、スケール時に2つのことがうまくいかなくなります。第一に、エージェントのプロンプトがプラットフォーム数に比例して大きくなります。新しいプラットフォームを追加するたびに、そのレスポンスの形を説明する段落が1つ増えます。プラットフォーム10個目には、プロンプトが呼び出しの中で最も遅い部分になります。
第二に、リトライとページネーションのコードが乗算的に大きくなります。ソース固有の癖がそれぞれ互いに作用し合い、「プラットフォームXで条件Yのときにカーソル後のリトライは機能するか」というマトリクスが爆発します。早期に正規化しないチームは、バグが出た後で、結局後から正規化レイヤーを書くことになります。
次に来るもの
現在のエンベロープは、リスト型のエンドポイントをきれいにカバーしています。私たちが取り組んでいる次のイテレーションは、ストリーミングやウェブフック型のソース、つまりレスポンスが一回限りの { data: [...] } ではなく、時間とともに連続するイベントである場所をカバーします。私たちはそれを、エージェントの側から非同期イテレーターのように感じられるよう形作っているので、プロンプトの変更は最小限で済みます。
もしあなたが今日マルチプラットフォームのエージェントを構築していて、このエンベロープが実際にどう機能するかを見たいなら、unifapi.com/skills のSkill から始めるか、unifapi.com/openapi.json でOpenAPI仕様を調べてください。すべてのエンドポイント、すべてのフィールドが、1つの形です。
次に読むべきもの
MCPカタログのツール設計 - エージェントがこのエンベロープを返す操作をどう発見するかを示します。
UnifAPI vs RapidAPI - 正規化を比較のポイントとして使います。
OpenAPI仕様 - 文章の裏にあるライブなスキーマを公開します。