
El stack mínimo viable de agentes para Skills de datos públicos

Actualizado
Guía de arquitectura para Skills de datos públicos: cliente de agente, runtime MCP, capa de datos unificada, observabilidad, costes y límites de fallo.
En resumen: este artículo de arquitectura es el punto de partida para los equipos que convierten Skills de hilos de chat en productos duraderos: cliente de agente, runtime de MCP, capa de datos públicos y observabilidad.
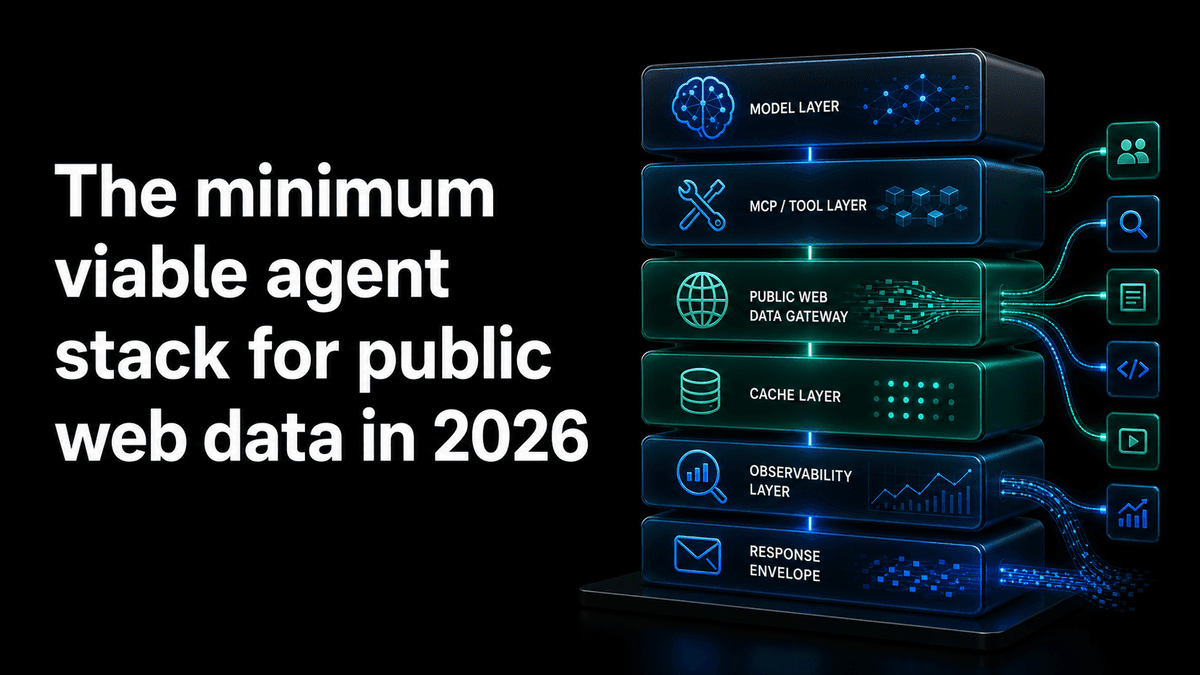
Crear un flujo de trabajo en producción que recurra a datos públicos necesita cuatro piezas y unas cuantas barreras de protección: un producto de agente bueno usando herramientas, un runtime de MCP, una capa unificada de datos públicos, observabilidad sobre lo que el agente llamó realmente y controles que mantengan el coste y el alcance inspeccionables. Todo lo que vaya más allá de eso debe ganarse su lugar.
Este es el stack que conservaríamos para Skills de datos públicos como la tarificación de KOL, el descubrimiento de creadores, el social listening, la inteligencia competitiva y la investigación de mercado. Es deliberadamente más pequeño que el diagrama completo de una plataforma de agentes, porque la mayoría de los equipos sobredimensionan la primera versión.
El stack de referencia
| Capa | Elección para desarrollo | Elección para producción | Lo que debe demostrar |
|---|---|---|---|
| Producto de agente | Claude, apps MCP personalizadas de ChatGPT, OpenClaw, Hermes, Codex, Claude Code, Cursor, VS Code | El runtime de agente en el que tu equipo ya confía | Puede llamar herramientas, inspeccionar resultados y revisar la salida |
| Runtime de MCP | URL de MCP alojado en el cliente | Servicio de agente con MCP de larga duración | Autenticación estable, descubrimiento de herramientas, ejecución de herramientas |
| Capa de datos públicos | UnifAPI MCP y APIs HTTP | Lo mismo, con alcances y presupuestos explícitos | Una envoltura, un modelo de facturación, registros públicos en vivo |
| Observabilidad | Transcripción del navegador/cliente más logs | Trazas de llamadas a herramientas, recuentos de registros, latencia, coste | Puede reproducir por qué cambió la respuesta |
| Persistencia | Copiar el resultado manualmente | Almacenar entradas de la ejecución, IDs de registros, salidas y decisiones | Puede comparar ejecuciones a lo largo del tiempo |
Las primeras cuatro capas son obligatorias. La persistencia pasa a ser obligatoria cuando el flujo de trabajo se repite o llega al cliente. Hasta entonces, el bucle de aprendizaje más rápido suele ser un hilo de agente más un prompt de Skill claro.
Capa 1: el producto de agente
El modelo elige las herramientas; el runtime las ejecuta. Los productos de agente modernos pueden gestionar el uso de herramientas en varios pasos sin mucho prompting si la tarea y la superficie de herramientas son claras. Para desarrollo, usa el producto en el que tu equipo ya vive: Codex para trabajo nativo en el repositorio, Claude Code para automatización de terminal y proyectos, Claude Desktop o Claude.ai para flujos de operador, Cursor cuando el trabajo empieza en el editor.
No empieces por construir una GUI personalizada salvo que el flujo de trabajo ya tenga entradas estables y un comprador recurrente. Una GUI congela el flujo de trabajo demasiado pronto. Una Skill permite al operador hacer preguntas de seguimiento, cambiar el mercado objetivo, solicitar una búsqueda más profunda o pedir al agente que explique su nivel de confianza antes de convertir nada en producto.
Capa 2: runtime de MCP
MCP es la capa de conexión entre el agente y los sistemas externos. Para las Skills de datos públicos, el runtime necesita exponer herramientas, gestionar la autenticación OAuth o por bearer, mostrar el estado de la conexión y dejar que el agente inspeccione las operaciones disponibles.
Los servidores MCP remotos por HTTP son ya la forma por defecto para los servicios alojados en la nube en los principales clientes de agente que revisamos. La referencia de Claude Code recomienda HTTP como opción para servidores remotos en la nube cuando está disponible. Cursor documenta Streamable HTTP como transporte remoto con OAuth. La página de Docs MCP de OpenAI muestra a Codex añadiendo un servidor MCP por Streamable HTTP mediante URL.
Para UnifAPI, eso significa que la Skill no debe pedir al usuario que instale un scraper local ni que pegue claves de API de plataformas. Debe pedirle que se conecte a https://mcp.unifapi.com, que se autentique con OAuth cuando haga falta, y dejar que el agente descubra las operaciones a través del catálogo MCP.
Capa 3: capa unificada de datos públicos
La API de datos unificada es el mayor punto de apalancamiento de todo este stack. Si tu agente termina llamando a un wrapper para Twitter/X, otro para Reddit, otro para YouTube y una hoja de cálculo para la tarificación de KOL, has construido un problema de integración multiproveedor antes de haber construido el flujo de trabajo del agente.
Empuja esa complejidad detrás de un único gateway. El catálogo en vivo de UnifAPI cubre TikTok, LinkedIn, Instagram, YouTube, Twitter/X, Threads, Reddit y Hacker News tras un único servidor MCP y un único contrato HTTP. El prompt del agente pasa a ser «ejecuta la Skill de tarificación de KOL» en lugar de «llama a profile_api, comments_api, search_api y luego cose una hoja de cálculo».
El requisito clave del producto no es solo la cobertura. Es un comportamiento de respuesta consistente: ids de petición predecibles, una carga útil de datos, paginación opcional, metadatos de facturación y errores normalizados. Esos detalles son los que permiten al agente recuperarse de un fallo parcial en lugar de inventarse una historia.
Capa 4: observabilidad y reproducción
Sin observabilidad, depuras a ciegas. El mínimo imprescindible para un agente de datos públicos en producción es una traza por ejecución que registre el prompt del usuario, cada llamada a herramienta, los argumentos, el estado de la respuesta, la duración, el recuento de registros devueltos, el recuento de registros facturados, la salida del modelo y la decisión final.
Una vez que puedes reproducir una ejecución, las regresiones dejan de ser un misterio. Una ejecución lenta suele deberse a una de cuatro cosas: latencia del modelo, latencia de la fuente pública, un prompt que se ramifica demasiado, o un bucle de reintentos provocado por una selección ambigua de operaciones. La traza debería decirte cuál de ellas fue.
| Qué registrar | Por qué importa |
|---|---|
| Tarea original del usuario | Explica la intención y las restricciones |
| Operación seleccionada | Muestra si el descubrimiento eligió la fuente correcta |
| Argumentos de query/body | Explica por qué una fuente devolvió esos registros |
| Recuento de registros y facturación | Hace el coste predecible |
| Decisiones de paginación | Muestra si la ejecución paró demasiado pronto o demasiado tarde |
| Confianza y supuestos | Mantiene auditable la respuesta final |
Capa 5: persistencia
No persistas todo el primer día. Persiste los datos mínimos que permitan a un usuario futuro entender o comparar la decisión. Para una ejecución de tarificación de KOL, almacena la entrada de la campaña, los handles de los creadores, los IDs o URLs de registros públicos, los rangos estimados, la confianza, los supuestos y las notas finales. Para el social listening, almacena la query, la fuente, la ventana temporal, los registros principales, los temas y un resumen.
La trampa es guardar la salida bruta de la herramienta sin guardar el contexto de la decisión. Un lector futuro necesita saber por qué el agente recuperó esos registros y qué se suponía que ayudaba a decidir la respuesta.
Controles de coste
Los agentes de datos públicos necesitan controles de coste explícitos porque el uso de herramientas puede ramificarse rápido. Una buena Skill fija un presupuesto de registros por defecto, explica cuánto cuesta una ejecución ligera y pregunta antes de pasar del cribado a la investigación profunda.
| Control | Valor por defecto para una primera versión |
|---|---|
| Tope de registros | 20-50 registros por fuente antes de preguntar si continuar |
| Alcance de plataforma | Empezar por la plataforma principal, enriquecer solo cuando haga falta |
| Paginación | Parar cuando los registros marginales dejan de cambiar la respuesta |
| Análisis profundos | Requerir confirmación explícita del usuario para la expansión multifuente |
| Salida | Devolver evidencia y supuestos para que el usuario decida si vale la pena más datos |
Dónde sigue fallando este stack
Primero, el OAuth a las cuentas SaaS propias del usuario es una categoría de integración distinta. Gmail, Linear, Notion, HubSpot y Salesforce son datos privados autorizados por el usuario. UnifAPI es para datos públicos. Usa una plataforma de conectores o un segundo servidor MCP para los sistemas privados del usuario.
Segundo, los flujos de trabajo en segundo plano de larga duración necesitan orquestación fuera del hilo de chat. Un resumen semanal, un rastreo nocturno o un monitor cada hora deberían usar un planificador, una cola duradera y una vía de notificación. La Skill puede definir la forma de la tarea, pero la entrega en producción necesita una capa de ejecución.
Tercero, los flujos de trabajo de navegador siguen siendo necesarios cuando el propio sitio web es la interfaz. Si el agente debe iniciar sesión en un portal, rellenar un formulario o navegar por un panel, usa un stack de agente de navegador. Si el agente necesita registros públicos repetibles, empieza por las APIs.
Un orden de construcción que te mantiene honesto
Empieza con una Skill en un cliente de agente. Añade UnifAPI MCP. Ejecuta cinco tareas reales a mano. Inspecciona los registros y las salidas finales. Añade un tope de coste. Añade registro de trazas. Solo entonces conviertes el flujo de trabajo en producto detrás de una UI de app o un trabajo programado.
El orden importa porque evita la infraestructura prematura. Si la Skill no puede producir una respuesta útil en un hilo de agente transparente, una UI más bonita no lo arreglará. Si puede producir una respuesta útil en un hilo, el camino hacia el producto se vuelve mucho más claro.
Fuentes consultadas
Esta guía de arquitectura se actualizó el 2 de junio de 2026 frente a la introducción oficial del Model Context Protocol, la página de Docs MCP de OpenAI, la referencia de MCP de Claude Code y la documentación de MCP de Cursor.
Qué leer a continuación
Diseño de herramientas del catálogo MCP - profundiza en la capa de operaciones de MCP.
Envoltura de respuesta unificada - cubre el contrato de datos del que depende el stack.
Skills de datos públicos Agent First - conecta la arquitectura con las Skills de cara al usuario.