
Skills de datos públicos Agent First: de las tareas a MCP

Actualizado
Guía central del modelo Skills-first de UnifAPI: flujos de tareas para agentes, MCP como vía de conexión y APIs de datos públicos como evidencia.
En resumen: este es el argumento central del clúster de blog Skills-first de UnifAPI: parte de una tarea del agente, conecta MCP cuando se necesita evidencia y mantén las APIs como la capa de datos públicos.
La primera versión de UnifAPI parecía un producto para desarrolladores: catálogo, endpoints, claves de API, documentación. Esa superficie sigue siendo necesaria para quien construye, pero no es la forma en que la mayoría de los operadores de agentes describen su trabajo. No se despiertan deseando un endpoint de Twitter. Quieren un brief de precios de KOL, una lista corta de creadores, un resumen del lanzamiento de un competidor, una ronda de investigación en Reddit o un informe de social listening con evidencia en la que puedan confiar.
Por eso la superficie de marketing de UnifAPI se trasladó a las Skills Agent First. Una Skill es un flujo de trabajo específico de una tarea que un agente puede ejecutar a través de UnifAPI MCP. El catálogo de API sigue siendo la capa de datos públicos bajo el flujo de trabajo; simplemente deja de ser lo primero que pedimos a un marketer o investigador que entienda.
La versión corta
| Capa | Lo que ve el usuario | Lo que usa el agente | Lo que aporta UnifAPI |
|---|---|---|---|
| Skill | Una tarea como precios de KOL, descubrimiento de creadores o investigación de mercado | Un prompt, una forma de salida esperada y un flujo de trabajo de seguimiento | La página de la tarea, el prompt de ejecución, los límites de datos y los ejemplos |
| MCP | Una URL de conector y un flujo de OAuth | Herramientas para descubrir, inspeccionar y llamar | list_operations, get_operation y call_api sobre el catálogo en vivo |
| API | Endpoints HTTP y OpenAPI | Contratos estables de solicitud/respuesta | Registros públicos nativos de cada plataforma, paginación, errores y metadatos de facturación |
El objetivo no es ocultar la API. Es colocarla en el nivel de abstracción correcto. Un desarrollador todavía puede invocar /apis/twitter o leer /openapi.json. Un operador debería poder empezar en /skills/kol-pricing, pegar un prompt en Codex o Claude Code, conectar https://mcp.unifapi.com y dejar que el agente obtenga evidencia cuando sea necesario.
Qué hace que algo sea una Skill
Una Skill empieza por un resultado, no por una fuente. Los buenos nombres de Skill suenan a trabajo que una persona asignaría: poner precio a una campaña de KOL, construir una lista corta de creadores, monitorizar un mercado, explicar a un competidor, mapear una comunidad de Reddit. Los malos nombres de Skill suenan a detalles de implementación: llamar a la búsqueda de Twitter, obtener comentarios de Reddit, listar vídeos de TikTok.
La página debería entonces responder a seis preguntas prácticas. ¿Qué resultado obtendré? ¿Qué datos de entrada necesito aportar? ¿Qué datos públicos puede usar el agente? ¿Cómo se verá la salida? ¿Qué no sabe este flujo de trabajo? ¿Qué debería preguntar a continuación si la primera respuesta es útil?
Esa última pregunta importa. Una Skill no es una mini app SaaS ni una plantilla estática. Es un flujo de trabajo conversacional. El agente puede pedir contexto de campaña que falta, ejecutar una búsqueda adicional en una plataforma, explicar su nivel de confianza, comparar dos creadores o acotar el resultado a otro mercado sin necesidad de una nueva GUI.
Un ejemplo concreto: precios de KOL
Los precios de KOL son el primer benchmark canónico porque son enrevesados de una forma que los flujos de trabajo de agentes manejan bien. Los datos públicos pueden mostrar la identidad del creador, su cadencia reciente de publicación, su engagement, su afinidad temática, señales de audiencia y notas de riesgo. No pueden conocer la tarifa real del creador, las condiciones del paquete, los derechos de uso, la exclusividad ni el historial de relación.
Una Skill útil mantiene ambos lados visibles. Pide al agente que devuelva un rango de tarifas, un nivel de confianza, evidencia, supuestos y preguntas de seguimiento, en lugar de fingir que conoce un precio exacto de patrocinio. Eso encaja mejor con el trabajo real del comprador: prepararse para la negociación, hacer una lista corta de los creadores adecuados y decidir dónde merece la pena dedicar tiempo a un acercamiento más profundo.
Por qué MCP cambia el onboarding
Antes de MCP, un operador a menudo tenía que elegir un proveedor de datos, crear una clave de API, entregar esa clave a una app, conectar un proveedor de LLM aparte y luego confiar en que la GUI coincidiera con el flujo de trabajo que tenía en mente. MCP cambia el orden. El usuario puede empezar por la tarea en el producto de agente que ya utiliza. OAuth se abre cuando el agente necesita llamar a las herramientas de UnifAPI o gastar créditos del espacio de trabajo.
El servidor MCP alojado de UnifAPI expone el catálogo a través de tres herramientas en lugar de una herramienta por endpoint. El agente usa list_operations para descubrir qué existe, get_operation para inspeccionar esquemas y ejemplos, y call_api para invocar una operación concreta de datos públicos. Eso mantiene compacta la superficie MCP incluso a medida que crece el catálogo de la API HTTP.
Esto también mantiene separados la ejecución del modelo y el acceso a los datos. El plan de agente del usuario se encarga del razonamiento del modelo. UnifAPI proporciona los registros de datos públicos en vivo y los factura en la capa de registros. Esa separación hace que una Skill sea más fácil de probar antes de convertirse en código de producto.
Por qué las APIs siguen importando
Las Skills necesitan datos fiables. El catálogo de API en vivo sigue siendo visible, buscable y documentado porque los desarrolladores seguirán convirtiendo flujos de trabajo funcionales en sistemas de producción. Lo que cambia es el orden: primero las Skills, después las APIs. El catálogo solo muestra las APIs ya publicadas para que un agente no intente llamar a entradas del roadmap.
La capa de API también protege a la Skill de la ingeniería de prompts imprecisa. Las operaciones de datos públicos tienen rutas con nombre, esquemas de parámetros, comportamiento de paginación, envelopes de respuesta y metadatos de facturación. Si el agente hace una mala llamada, la traza debería mostrar si el problema fue el prompt, la elección de la operación, la respuesta del proveedor o la capa de reshape.
Qué pertenece a una página de Skill
Una buena página de Skill debería incluir una descripción del trabajo en lenguaje claro, un prompt de ejecución copiable, los datos de entrada requeridos, los opcionales, las APIs de datos públicos implicadas, una plantilla de salida esperada, expectativas de coste, reglas de confianza, límites de riesgo y Skills relacionadas. La página también debería exponer una versión alternativa en markdown para que otro agente pueda leer el flujo de trabajo sin depender del diseño visual.
| Sección | Por qué ayuda a una persona | Por qué ayuda a un agente |
|---|---|---|
| Prompt de ejecución | Permite al usuario empezar de inmediato | Aporta la tarea, las restricciones y la forma de salida |
| Fuentes de datos | Muestra qué evidencia hay disponible | Acota el descubrimiento de operaciones |
| Plantilla de salida | Establece expectativas | Reduce la síntesis imprecisa |
| Límites | Evita afirmaciones excesivas | Fuerza la incertidumbre y las preguntas de seguimiento |
| Skills relacionadas | Da el siguiente flujo de trabajo | Construye contexto interno y vías de recuperación |
Forma de búsqueda y descubrimiento por IA
Para la búsqueda, las Skills coinciden con el lenguaje que los usuarios ya emplean: agente de precios de KOL, agente de investigación de creadores, Skills de datos públicos para agentes, Skills MCP para investigación de marketing, agente de inteligencia competitiva. Para la búsqueda con IA y la recuperación por agentes, los mismos hechos deben estar disponibles en HTML, markdown, datos estructurados, llms.txt y enlaces internos.
El objetivo no es engañar a los motores de búsqueda ni a las respuestas de IA. Es hacer que la página coincida con el trabajo real que el usuario intenta realizar, y luego exponer los mismos hechos fiables en varios formatos rastreables. Eso también mantiene honesto al sitio: si la página de la Skill dice que el flujo de trabajo puede hacer algo, el catálogo MCP y el contrato de API deberían respaldarlo.
Nota sobre las fuentes
Este artículo se actualizó el 2 de junio de 2026 frente al contexto actual del producto UnifAPI, las superficies en vivo de Skills/API y la introducción oficial al Model Context Protocol. Trata intencionadamente las Skills como guía de flujo de trabajo y MCP como vía de conexión, en lugar de afirmar que cada endpoint de API es una herramienta MCP separada.
Qué leer a continuación
Ejecuta un agente de precios de KOL con MCP - convierte el posicionamiento de las Skills en un flujo de trabajo concreto.
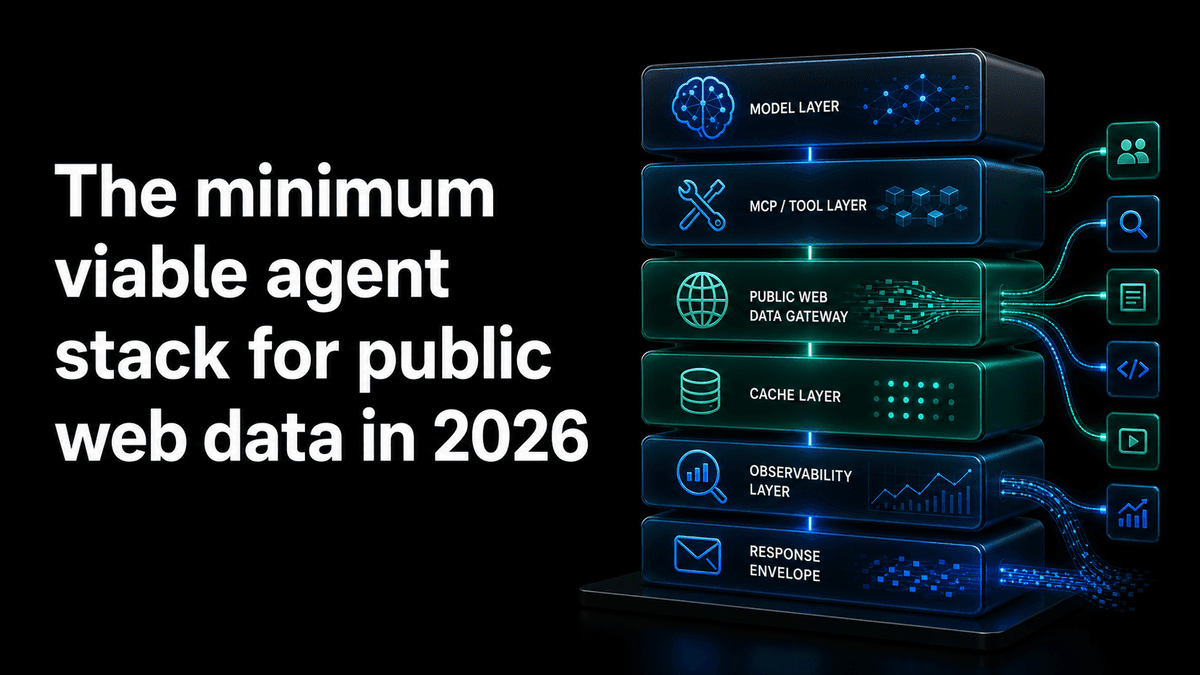
Stack mínimo viable de agentes - muestra el stack detrás de una Skill de datos públicos repetible.
Explora las Skills de UnifAPI - pasa de la estrategia a las páginas de tareas en vivo.