
UnifAPI 对比 TinyFish:公开数据 Skills 与浏览器 Agent

更新于
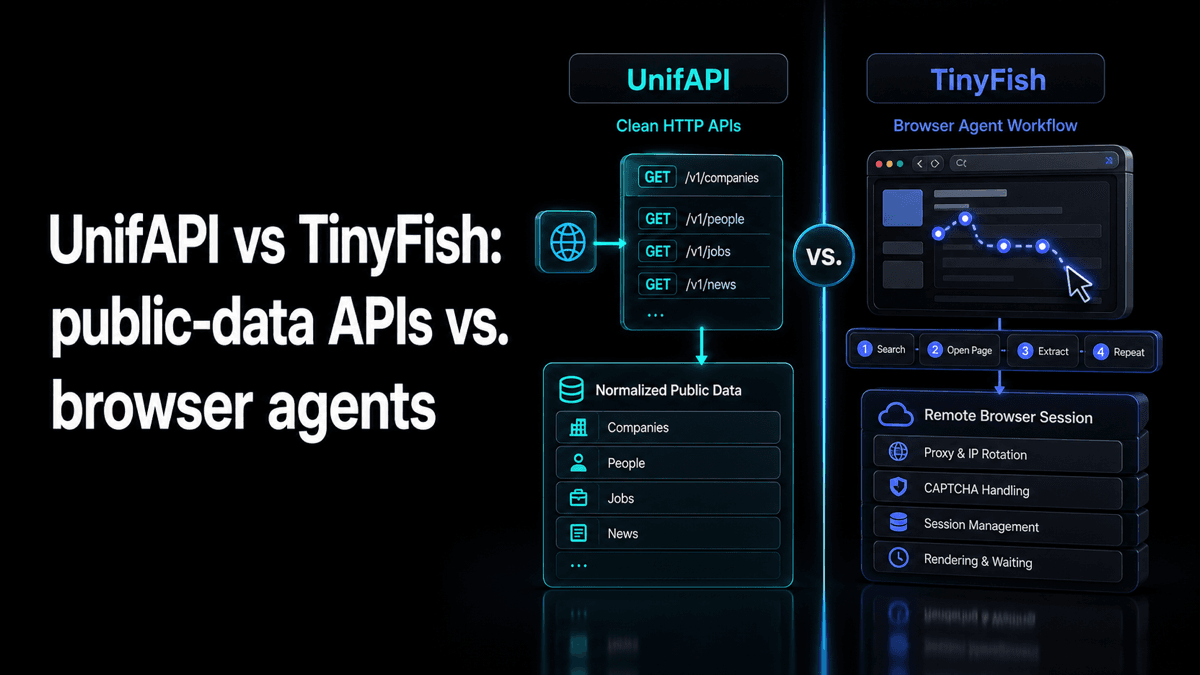
TinyFish 式的浏览器 Agent 负责操作网站。UnifAPI 则在 MCP 背后为 Agent 提供结构化公开数据与 Skills。这是何时该用哪一种的判断指南。
一句话总结:本文面向「TinyFish 替代方案」的搜索,把选择重新框定为「浏览器工作流」对「结构化公开数据记录」。
TinyFish 和 UnifAPI 都在回答同一个问题:AI Agent 该如何使用网络,而不必靠人手把页面复制粘贴进提示词?答案分裂为两个截然不同的层。TinyFish 式产品是浏览器 Agent 基础设施:search、fetch、browser 和 agent 这几类 API,能渲染页面、驱动工作流、填写表单并返回抽取出的结果。UnifAPI 则是一个公开数据层:面向社交与开放网络证据的平台原生记录,在 MCP 和一套统一响应封装背后做了归一化。
如果你在找 TinyFish 的替代方案,第一个要做的决定不是「这家厂商对那家厂商」,而是「浏览器工作流对结构化数据 API」。当 Agent 确实必须去操作一个网站时,选 TinyFish。当数据本身已经有了可重复获取的公开界面、而浏览器只会徒增延迟、成本和故障模式时,选 UnifAPI。
TinyFish 对 UnifAPI:速览答案
| 维度 | TinyFish | UnifAPI |
|---|---|---|
| 核心抽象 | Search、Fetch、Browser 会话,以及目标驱动的 Agent 运行 | 公开数据 Skills 加上 MCP 背后的精选 API |
| 最佳边界 | 动态页面、表单、登录墙、反爬流程,以及没有 API 的站点 | 直连端点能胜任的公开社交记录 |
| 执行模型 | 一个真实浏览器去渲染、点击、等待并抽取 | HTTP 调用返回归一化的 JSON 记录 |
| 计费单位 | 视产品而定的浏览器会话、步骤、积分或动作时长 | 操作积分:每次 $0.001,最低消耗在 OpenAPI 中公布 |
| Agent 集成 | MCP、SDK、CLI,以及 Search、Fetch、Browser、Agent 等工具 | MCP 优先,外加面向平台原生公开数据的 OpenAPI/HTTP 端点 |
| 何时它更胜一筹 | 任务需要与站点交互 | 任务需要大批量、可重复获取的公开数据 |
TinyFish 为什么而优化
TinyFish 式的浏览器平台通常暴露几个界面:搜索结果、渲染后的抓取、远程浏览器会话,以及目标驱动的 Agent 运行。对那些普通 API 不够用的任务来说,这是一种很强的形态。
对那些普通 API 不够用的任务来说,这是一种很强的形态:从供应商门户拉数据、填写一份保险报价表单、查看一个动态目录,或使用一个只有在 JavaScript、凭据或多次点击之后才暴露正确数据的站点。TinyFish 在努力把浏览器做得足够可编程,以支撑生产级 Agent。
代价在于,浏览器工作流终究还是一套工作流。Agent 得加载页面、等待渲染、从 UI 漂移中恢复,并按步骤或浏览器会话时长来消耗积分。当浏览器确有必要时,这份成本是合理的。但当目标数据本就能作为一条结构化公开记录获取时,浏览器通常是个错误的抽象。
UnifAPI 为什么而优化
UnifAPI 从相反的假设出发:大多数公开数据 Agent 工作流根本就不该打开浏览器。一个社交监听 Agent 应当通过稳定的端点去调用 TikTok、Reddit、YouTube、LinkedIn、Instagram、Twitter/X 或 Threads。它应当收到带分页、带元数据、错误可预期的记录,而不该去推理 DOM 节点。
这个产品界面刻意比一个完整的浏览器平台要窄。UnifAPI 不会登录用户的私有账户、不会点击按钮、不会填写表单。它给 Agent 提供的是公开数据层:一个鉴权头、一份账单、一个统一封装,以及每次 $0.001、最低消耗公开的操作积分。对于高吞吐的调研、监控、创作者发现、竞争情报和市场分析来说,这个单位比浏览器分钟数或 Agent 步骤更容易做预算。
定价:积分对记录
浏览器 Agent 产品通常按步骤、浏览器时长或积分计费,因为它们是在执行一套工作流。UnifAPI 按记录计费,而非按步骤或时长。一次返回 20 条记录的调用花费 $0.02。一页 50 条记录的创作者调研花费 $0.05。这个对比并非苹果对苹果:TinyFish 为执行浏览器工作而收费,UnifAPI 为返回的数据而收费。真正实际的问题是,你的工作流一开始究竟需不需要浏览器工作。
输出形态对 Agent 很重要
TinyFish 的输出是围绕任务来组织的:搜索结果、抽取出的页面内容、一个浏览器连接 URL,或一次 Agent 运行的结果。当 Agent 的工作就是操作一个网站并返回最终答案时,这正是你想要的。
UnifAPI 的输出是围绕记录来组织的。Agent 拿到的是帖子、视频、档案、评论、搜索结果以及相关平台元数据的列表,全部装在一个一致的封装里。当 Agent 必须对同一个数据源反复地比较、排名、筛选、分页、丰富和回访时,这正是你想要的。
何时 TinyFish 是更好的选择
如果网站本身就是界面,那就选 TinyFish。例如:登录某个供应商门户并下载最新价目表;完成一份多步骤报价表单;查看一个没有公开 API 的仪表盘;从一个静态抓取会失败、JavaScript 繁重的页面里抽取内容;把你自己的 Playwright 代码交给一个隐身的远程浏览器会话去跑。
当你的产品需要向 Agent 暴露一个通用的网页动作工具时,TinyFish 也说得通。用户说出他想在某个站点上完成什么,Agent 就去尝试浏览、点击、等待并抽取。那不是 UnifAPI 的赛道。
何时 UnifAPI 是更好的选择
如果你的 Agent 需要的是公开的平台数据,而非与网站交互,那就选 UnifAPI。例如:跨 Reddit、TikTok、YouTube 和 Twitter/X 监控品牌提及;拉取创作者档案和近期帖子;跨各支持的社交平台对比一次产品发布的讨论热度;用平台原生的元数据——如互动数、评论、作者、时间戳和分页游标——来丰富一份调研简报。
在这些工作流里,为每一个数据源都打开一个浏览器既昂贵又脆弱。Agent 想要的是数据,不是一块屏幕。UnifAPI 把集成数量保持在一个,让模型把它的 token 花在综合归纳上,而不是浏览器恢复上。
TinyFish 与 UnifAPI 搭配使用
最强的架构往往是混合式的。可重复获取的公开数据层用 UnifAPI:通过端点去发现帖子、档案、视频、评论和趋势。当工作流触及一个必须像人类那样去操作的站点时——一份表单、一个账户门户、一个受保护的目录,或一个没有稳定数据界面的动态页面——则用 TinyFish。
这种分工让两个工具都保持诚实。UnifAPI 不该假装自己是一个万能浏览器。TinyFish 也不该被迫为一条直连端点本能更快返回的记录去消耗浏览器步骤。把公开数据放在 API 背后,把杂乱的网站放在浏览器 Agent 背后,让 Agent 优先去选那个更轻的工具。
结论
对 AI 浏览器自动化而言,TinyFish 是一个值得认真考虑的选择。它在需要鉴权的、动态的或交互式的网页工作流上尤其有吸引力。而对结构化公开数据访问而言,当 Agent 需要从众多平台拿到一致的记录、可预期的计费、Skills 和一份就绪的 MCP 目录时,UnifAPI 是更好的选择。
决定性的问题很简单:Agent 是需要使用这个网站,还是需要网站背后的数据?如果它需要的是网站,从 TinyFish 起步。如果它需要的是数据,从 UnifAPI 起步。
推荐延伸阅读
UnifAPI 对比 Browserbase / Stagehand - 对比一套密切相关的浏览器 Agent 技术栈。
UnifAPI 对比 Firecrawl / Tavily - 把页面抽取和公开数据记录区分开来。
对比各类替代方案 - 让所有厂商定位页面保持可被发现。