
Agent First 架构:Agents、Skills、MCP 与 APIs
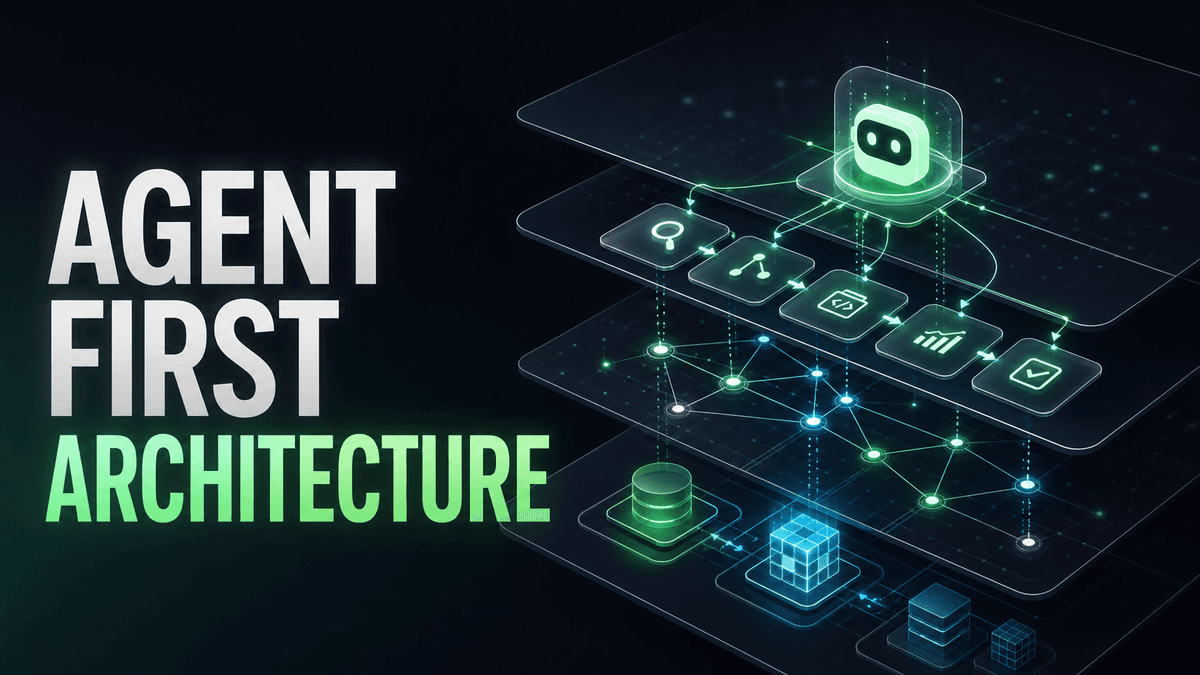

为什么 UnifAPI 以营销 Agents 为先、把 Skills 作为工作流加载,并以 SEO、GEO、浏览器与社交 API 作为证据层。
一句话概括:UnifAPI 如今从一名营销人员想要委派给 Claude、Codex 或另一个支持 MCP 的助手的工作出发。Agents 是产品界面,Skills 是可执行的操作手册,MCP 是连接路径,而 APIs 是实时的公开数据证据层。
UnifAPI 的第一个版本对开发者很好解释:一个 API 密钥、一份 OpenAPI 契约、众多公开数据端点。这至今仍然成立,但对于一名想让助手去做营销调研的操作者来说,它不再是最有用的开场白。
操作者不会去要"那一族 SEO 端点"或"一次渲染后的 Browser Markdown 调用"。他们要的是一次排名审计、一份 GEO 可见性报告、一个创作者候选名单、一份竞品简报、一次本地 pack 扫描,或一份内容机会备忘录。Agent First 架构正是从这里起步。
四个层级
| 层级 | 含义 | 示例 |
|---|---|---|
| Agent | 你在助手内部运行的、有名字的营销角色 | SEO Agent、AI Visibility Agent、Competitive Intelligence Agent |
| Skill | 以 SKILL.md 操作手册实现的单项能力 | seo-audit、ai-answer-gap、competitor-profiling |
| MCP | 让助手能够调用 UnifAPI 的连接路径 | list_operations、get_operation、call_api |
| API | 工作流背后的实时公开数据契约 | /seo/serp、/geo/serp、/browser/markdown |
这套技术栈之所以重要,是因为每一层都有不同的职责。Agent 命名结果。Skill 告诉助手如何完成工作。MCP 处理鉴权、发现与调用。API 返回可被引用的记录。
这种分离让产品保持诚实。如果一个 Skill 声称能检查 AI 可见性,那么 GEO API 就必须返回答案、引用、提及与搜索量记录。如果一个 SEO Agent 声称能检查一个页面,那么 Browser API 就必须返回渲染后的 Markdown 或 HTML,而不只是一个 URL 字符串。
为什么 Agents 居首
UnifAPI Agents 不是托管的机器人。你在自己已经在用的助手内部运行它们,例如 Claude 或 Codex。UnifAPI 通过 MCP 提供角色、Skills 与公开数据。
这种措辞是刻意的。运行时是你的助手。UnifAPI Agent 是角色专属的工作流封装。数据层是 UnifAPI。
这给了操作者一个简单的心智模型:
- 选择与工作匹配的 Agent。
- 连接 UnifAPI MCP 一次。
- 粘贴或加载 Agent 提示词。
- 让助手去获取它所需的公开证据。
- 审阅那份带引用的简报,再决定下一步做什么。
同一套技术栈也能服务开发者。开发者可以绕过这套散文式工作流,直接调用 HTTP API,但面向大众的营销层不应让每一个非开发者都先去学 API 目录。
Skills 带来的变化
Skills 不再只是博客选题或示例。它们是让一个 Agent 可复用的实现产物。
一个好的 Skill 命名一项具体能力:审计 SEO、追踪 LLM 提及、调研一个 LinkedIn 账号、搭一个创作者候选名单、扫描本地竞品,或为一个竞品画像。它应当包含触发短语、输入清单、要使用的公开数据调用、输出形态、置信度规则与边界。
这正是为什么一个 Skill 比一段提示词片段更有用。提示词能要一个结果,而 Skill 能把工作流、数据源的选择,以及预期的证据标准都编码进去。
为什么 API 目录仍然重要
API 目录仍然是实时数据的真相来源。SEO、GEO、Browser、本地、社交、新闻、出行与活动,全都通过统一契约发布端点。
区别在于操作者从哪里进入:
| 用户意图 | 最佳入口 |
|---|---|
| "为这些关键词审计排名" | SEO Agent |
| "追踪 ChatGPT 是否引用了我们" | AI Visibility Agent |
| "读取这个重度依赖 JavaScript 的页面" | Browser API 或 SEO Skill |
| "搭一个创作者候选名单" | Influencer Marketing Agent |
| "在我自己的应用里集成公开数据" | HTTP API 文档 |
这套架构让 UnifAPI 能在不把产品变成一份巨型端点菜单的前提下增加更多 APIs。当新的 API 覆盖被接入一个 Skill 与一个 Agent 结果时,它才会变得更有用。
只读边界
当前的产品是"眼睛,而非双手"。UnifAPI 读取公开数据。它不发帖、不发布、不编辑列表、不投广告、不给线索发消息,也不持有上游的发布凭证。
Agent 仍然可以建议行动步骤。SEO Agent 可以指出该改进哪个页面。AI Visibility Agent 可以解释哪些来源需要更好的引用覆盖。Social Selling Agent 可以草拟接触角度。而执行这些行动的,是操作者和他们自己的工具。
这条边界是良好的产品纪律。它让鉴权保持简单,保护用户免于意外的写操作,并让每一份输出都可供审阅。
一次示例运行
给 SEO Agent 一个域名和一组关键词。助手加载 SEO Skills,通过 UnifAPI MCP 连接,调用实时 SEO 记录,使用 Browser Markdown 做渲染后页面检查,然后返回:
| 板块 | 证据 |
|---|---|
| 排名摘要 | 每个查询的自然与 AI SERP 排名 |
| 可见性缺口 | 竞品排名或被引用的那些查询 |
| 页面诊断 | 渲染后的页面标题、链接与内容区块 |
| 修复计划 | 按优先级排序的改动,标注为建议、而非行动 |
| 来源日志 | 已调用的操作、用到的记录,以及置信度说明 |
操作者在拿到第一个有用答案之前,无需先了解整棵端点树。但端点树仍然在那里,供可追溯性与生产使用。
主要参考
本文的架构框定应与官方的 Model Context Protocol 架构总览保持一致。MCP 描述了一个 host、client 与 server 的模型,并带有 tools、resources 与 prompts 等原语;UnifAPI 的产品语言把这些原语映射到上文那些面向操作者的层级。
对于内容与实体标记,生成的博客页面使用 schema 兼容的文章元数据;可对照 Schema.org Article 与 Schema.org BlogPosting 中的公开词汇。对于面向搜索的页面基本功,应让实现与 Google 的 SEO 入门指南保持一致。
接下来读什么
SEO Agent 实时排名审计 - 经典排名追踪的角色化 agent 版本。
面向 GEO 的 AI Visibility Agent - GEO 记录如何支撑答案引擎可见性工作。
面向 agent 网页阅读的 Browser API - 为什么渲染后的页面是营销 Agents 的一项辅助能力。