
공개 데이터 Skills를 위한 최소 실행 가능 에이전트 스택

업데이트
공개 데이터 Skills를 위한 실용 아키텍처 가이드: 에이전트 클라이언트, MCP 런타임, 통합 데이터 레이어, 관측성, 비용 제어, 그리고 실패 경계.
요약: 이 아키텍처 글은 채팅 스레드 수준의 Skills를 견고한 제품으로 바꾸려는 팀을 위한 허브입니다: 에이전트 클라이언트, MCP 런타임, 공개 데이터 레이어, 그리고 관측성.
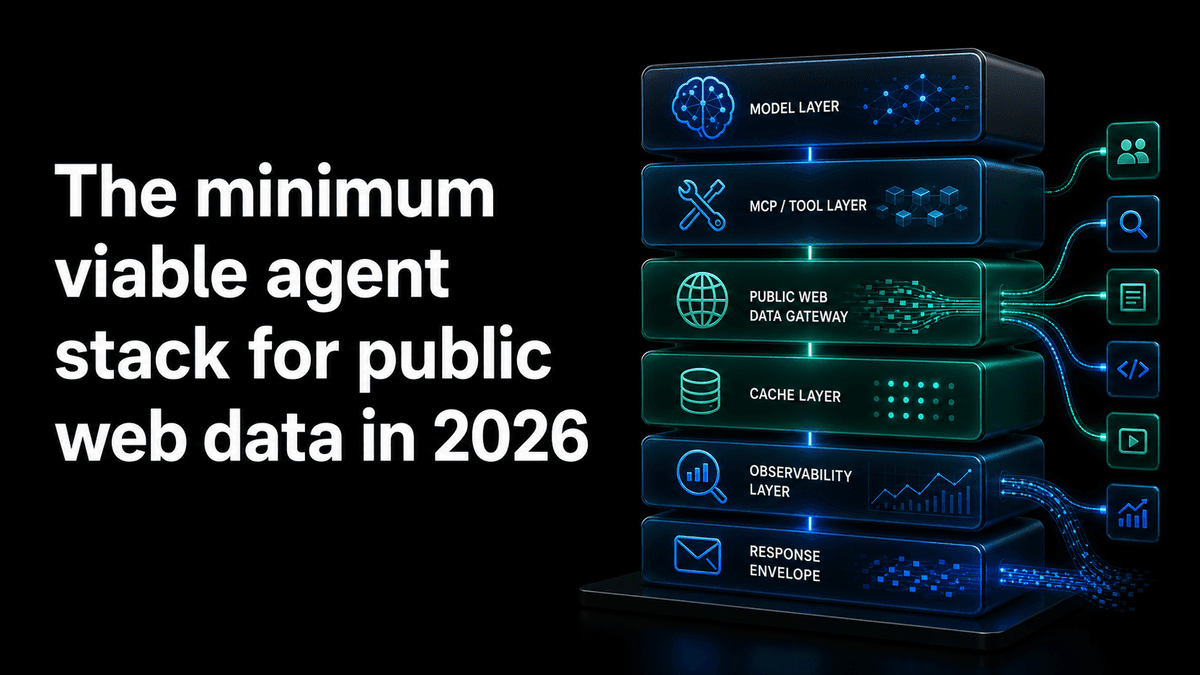
공개 데이터에 손을 뻗는 프로덕션 워크플로를 구축하려면 네 가지 조각과 몇 가지 가드레일이 필요합니다. 도구 사용에 능한 에이전트 제품, MCP 런타임, 통합 공개 데이터 레이어, 에이전트가 실제로 무엇을 호출했는지에 대한 관측성, 그리고 비용과 범위를 검사 가능하게 유지하는 제어입니다. 그 이상의 모든 것은 자리를 차지할 자격을 입증해야 합니다.
이것이 KOL 가격 책정, 크리에이터 발굴, 소셜 리스닝, 경쟁 인텔리전스, 시장 조사 같은 공개 데이터 Skills를 위해 우리가 유지할 스택입니다. 대부분의 팀이 첫 버전을 과하게 만들기 때문에, 이 스택은 전체 에이전트 플랫폼 다이어그램보다 의도적으로 더 작습니다.
레퍼런스 스택
| 레이어 | 개발 단계 선택 | 프로덕션 선택 | 무엇을 입증해야 하는가 |
|---|---|---|---|
| 에이전트 제품 | Claude, ChatGPT 커스텀 MCP 앱, OpenClaw, Hermes, Codex, Claude Code, Cursor, VS Code | 팀이 이미 신뢰하는 에이전트 런타임 | 도구를 호출하고, 결과를 검사하고, 출력을 수정할 수 있음 |
| MCP 런타임 | 클라이언트의 호스팅 MCP URL | 수명이 긴 MCP 지원 에이전트 서비스 | 안정적인 인증, 도구 발견, 도구 실행 |
| 공개 데이터 레이어 | UnifAPI MCP 및 HTTP API | 동일하되, 명시적 범위와 예산 추가 | 하나의 envelope, 하나의 과금 모델, 실시간 공개 record |
| 관측성 | 브라우저/클라이언트 트랜스크립트와 로그 | 도구 호출 트레이스, record 수, 지연, 비용 | 답이 왜 바뀌었는지 재현할 수 있음 |
| 영속성 | 결과를 수동으로 복사 | 실행 입력값, record ID, 출력, 결정을 저장 | 시간에 걸쳐 실행을 비교할 수 있음 |
처음 네 레이어는 필수입니다. 영속성은 워크플로가 반복되거나 고객을 대면하는 순간 필수가 됩니다. 그전까지 가장 빠른 학습 루프는 보통 에이전트 스레드와 명확한 Skill 프롬프트입니다.
레이어 1: 에이전트 제품
모델이 도구를 고르고, 런타임이 이를 실행합니다. 현대 에이전트 제품은 작업과 도구 표면이 명확하면 많은 프롬프팅 없이도 다단계 도구 사용을 처리할 수 있습니다. 개발 단계에서는 팀이 이미 머무는 제품을 쓰세요. 레포 네이티브 작업에는 Codex, 터미널과 프로젝트 자동화에는 Claude Code, 운영자 워크플로에는 Claude Desktop이나 Claude.ai, 작업이 에디터에서 시작될 때는 Cursor입니다.
워크플로가 이미 안정적인 입력값과 반복 구매자를 갖지 않은 한, 커스텀 GUI를 만드는 것으로 시작하지 마세요. GUI는 워크플로를 너무 일찍 얼립니다. Skill은 어떤 것을 제품화하기 전에 운영자가 후속 질문을 하고, 타깃 시장을 바꾸고, 더 깊은 검색을 요청하고, 에이전트에게 신뢰도를 설명하라고 요청하게 해 줍니다.
레이어 2: MCP 런타임
MCP는 에이전트와 외부 시스템 사이의 연결 레이어입니다. 공개 데이터 Skills의 경우, 런타임은 도구를 노출하고, OAuth나 베어러 인증을 처리하고, 연결 상태를 보여주고, 에이전트가 사용 가능한 작업을 검사하게 해야 합니다.
원격 HTTP MCP 서버는 이제 우리가 확인한 주요 에이전트 클라이언트에서 클라우드 호스팅 서비스의 기본 형태입니다. Claude Code의 레퍼런스는 가능한 경우 원격 클라우드 서버에 대해 HTTP를 권장 옵션으로 부릅니다. Cursor는 Streamable HTTP를 OAuth가 있는 원격 전송으로 문서화합니다. OpenAI의 Docs MCP 페이지는 Codex가 URL로 Streamable HTTP MCP 서버를 추가하는 모습을 보여줍니다.
UnifAPI의 경우, 이는 Skill이 사용자에게 로컬 스크래퍼를 설치하거나 플랫폼 API 키를 붙여넣으라고 요청하면 안 된다는 뜻입니다. https://mcp.unifapi.com을 연결하고, 필요할 때 OAuth로 인증하고, 에이전트가 MCP 카탈로그를 통해 작업을 발견하게 해야 합니다.
레이어 3: 통합 공개 데이터 레이어
통합 데이터 API는 이 스택에서 단일 최대 레버리지 지점입니다. 만약 당신의 에이전트가 Twitter/X에는 하나의 래퍼, Reddit에는 다른 래퍼, YouTube에는 또 다른 래퍼, KOL 가격에는 스프레드시트를 호출하게 된다면, 당신은 에이전트 워크플로를 만들기도 전에 다중 벤더 통합 문제를 만든 것입니다.
그 복잡성을 하나의 게이트웨이 뒤로 밀어 넣으세요. UnifAPI의 실시간 카탈로그는 TikTok, LinkedIn, Instagram, YouTube, Twitter/X, Threads, Reddit, Hacker News를 하나의 MCP 서버와 하나의 HTTP 계약 뒤에서 커버합니다. 에이전트 프롬프트는 'profile_api, comments_api, search_api를 호출한 다음 스프레드시트를 꿰매라'가 아니라 'KOL 가격 책정 Skill을 실행하라'가 됩니다.
핵심 제품 요구사항은 단지 커버리지가 아닙니다. 일관된 응답 동작입니다. 예측 가능한 request id, 데이터 페이로드, 선택적 페이지네이션, 과금 메타데이터, 그리고 정규화된 오류입니다. 이런 세부사항이 에이전트가 이야기를 지어내는 대신 부분 실패에서 복구하게 해 줍니다.
레이어 4: 관측성과 재현
관측성 없이는 눈을 감고 디버깅하게 됩니다. 프로덕션 공개 데이터 에이전트의 최소한은, 사용자 프롬프트, 모든 도구 호출, 인자, 응답 상태, 소요 시간, 반환된 record 수, 과금된 record 수, 모델 출력, 그리고 최종 결정을 기록하는 실행당 트레이스입니다.
실행을 재현할 수 있게 되면, 회귀는 더 이상 미스터리가 아닙니다. 느린 실행은 보통 네 가지 중 하나입니다. 모델 지연, 공개 출처 지연, 너무 넓게 펼쳐지는 프롬프트, 또는 모호한 작업 선택으로 인한 재시도 루프입니다. 트레이스가 그것이 어느 것이었는지 알려줘야 합니다.
| 무엇을 로깅할까 | 왜 중요한가 |
|---|---|
| 원래 사용자 작업 | 의도와 제약을 설명함 |
| 선택된 작업 | 발견이 올바른 출처를 골랐는지 보여줌 |
| Query/body 인자 | 출처가 왜 그 record를 반환했는지 설명함 |
| Record 수와 과금 | 비용을 예측 가능하게 만듦 |
| 페이지네이션 결정 | 실행이 너무 일찍 멈췄는지 너무 늦게 멈췄는지 보여줌 |
| 신뢰도와 가정 | 최종 답을 감사 가능하게 유지함 |
레이어 5: 영속성
첫날부터 모든 것을 영속화하지 마세요. 미래의 사용자가 결정을 이해하거나 비교할 수 있게 하는 최소한의 사실만 영속화하세요. KOL 가격 책정 실행이라면 캠페인 입력값, 크리에이터 핸들, 공개 record ID나 URL, 추정 범위, 신뢰도, 가정, 그리고 최종 메모를 저장하세요. 소셜 리스닝이라면 query, 출처, 시간 윈도, 상위 record, 테마, 그리고 요약을 저장하세요.
함정은 결정 맥락을 저장하지 않고 원시 도구 출력만 저장하는 것입니다. 미래의 독자는 에이전트가 왜 그 record를 가져왔는지, 그리고 그 답이 무엇을 결정하는 데 도움이 되려 했는지 알아야 합니다.
비용 제어
공개 데이터 에이전트는 도구 사용이 빠르게 펼쳐질 수 있기 때문에 명시적 비용 제어가 필요합니다. 좋은 Skill은 기본 record 예산을 설정하고, 가벼운 실행의 비용을 설명하며, 스크리닝에서 심층 조사로 넘어가기 전에 물어봅니다.
| 제어 | 첫 버전의 기본값 |
|---|---|
| Record 상한 | 계속할지 묻기 전 출처당 record 20~50개 |
| 플랫폼 범위 | 주요 플랫폼에서 시작하고, 필요할 때만 보강 |
| 페이지네이션 | 한계 record가 답을 더 이상 바꾸지 않을 때 중단 |
| 심층 조사 | 다중 출처 확장에는 명시적 사용자 확인 요구 |
| 출력 | 증거와 가정을 반환하여 더 많은 데이터가 가치 있는지 사용자가 판단하게 함 |
이 스택이 여전히 실패하는 곳
첫째, 사용자 본인의 SaaS 계정으로의 OAuth는 다른 통합 카테고리입니다. Gmail, Linear, Notion, HubSpot, Salesforce는 사용자 인가 기반의 비공개 데이터입니다. UnifAPI는 공개 데이터를 위한 것입니다. 사용자의 비공개 시스템에는 커넥터 플랫폼이나 두 번째 MCP 서버를 사용하세요.
둘째, 장기 실행 백그라운드 워크플로는 채팅 스레드 바깥의 오케스트레이션이 필요합니다. 주간 다이제스트, 야간 크롤, 시간 단위 모니터는 스케줄러, 견고한 큐, 그리고 알림 경로를 사용해야 합니다. Skill은 작업 형태를 정의할 수 있지만, 프로덕션 전달에는 실행 레이어가 필요합니다.
셋째, 웹사이트 자체가 인터페이스일 때는 브라우저 워크플로가 여전히 필요합니다. 에이전트가 포털에 로그인하거나, 폼을 채우거나, 대시보드를 탐색해야 한다면 브라우저 에이전트 스택을 사용하세요. 에이전트가 반복 가능한 공개 record가 필요하다면 API로 시작하세요.
당신을 정직하게 유지하는 빌드 순서
하나의 에이전트 클라이언트에서 하나의 Skill로 시작하세요. UnifAPI MCP를 추가하세요. 실제 작업 다섯 개를 손으로 실행하세요. record와 최종 출력을 검사하세요. 비용 상한을 추가하세요. 트레이스 로깅을 추가하세요. 그런 다음에야 앱 UI나 예약 작업 뒤로 워크플로를 제품화하세요.
순서가 중요한 이유는 조급한 인프라를 막아주기 때문입니다. Skill이 투명한 에이전트 스레드에서 유용한 답을 내놓지 못한다면, 더 멋진 UI가 그것을 고치지 못합니다. 스레드에서 유용한 답을 낼 수 있다면, 제품화 경로는 훨씬 더 명확해집니다.
확인한 출처
이 아키텍처 가이드는 2026년 6월 2일에 공식 Model Context Protocol 소개, OpenAI Docs MCP 페이지, Claude Code MCP 레퍼런스, 그리고 Cursor의 MCP 문서에 비추어 갱신되었습니다.
다음에 읽을 글
MCP 카탈로그 도구 설계 - MCP 작업 레이어를 깊이 파고듭니다.
통합 응답 봉투 - 이 스택이 의존하는 데이터 계약을 다룹니다.
Agent First 공개 데이터 Skills - 아키텍처를 사용자 대면 Skills로 다시 연결합니다.