ツイートへの返信をプログラムから読む方法

更新日
任意の X 投稿への公開返信を JSON か Markdown で返す無料エンドポイント。エンゲージメント順か時系列で、カーソルページング付き。
要点:
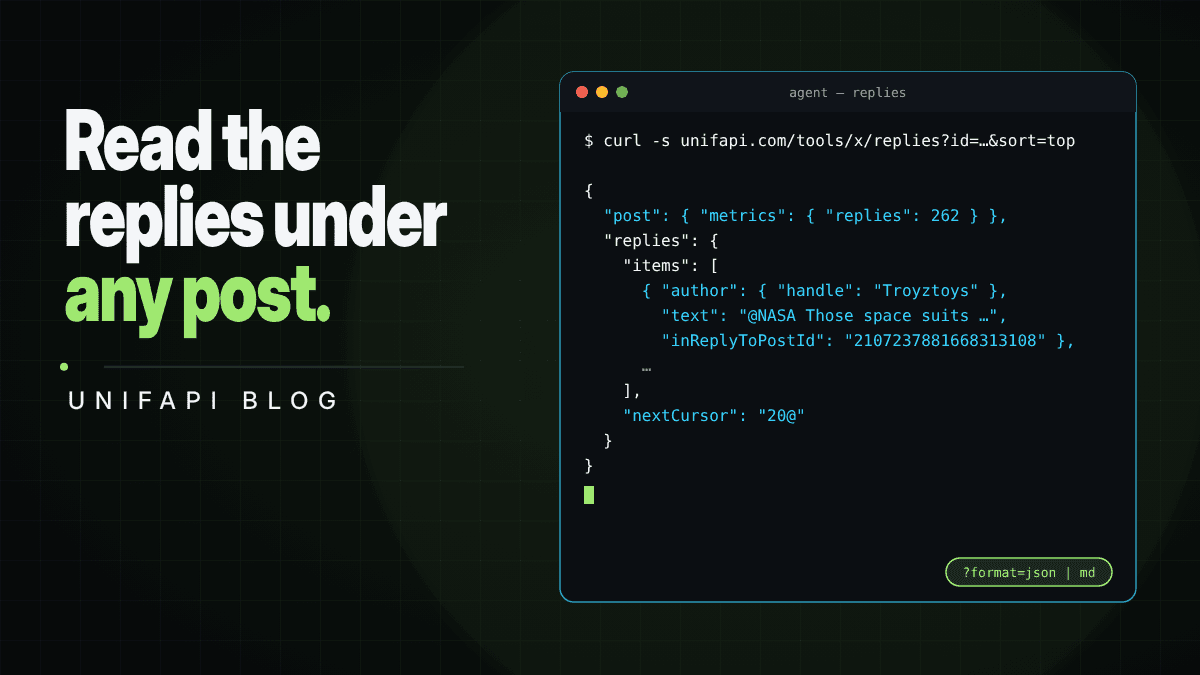
GET https://unifapi.com/tools/x/replies?id=<post id or URL>は、投稿とその下の公開返信を JSON で返します。無料で使え、ログインもアカウントも API キーも不要で、訪問者ごとのレート制限があります。sort=top(デフォルト)はエンゲージメント順、sort=recentは時間順です。1 ページは返信 20 件で、nextCursorが付きます。各返信には著者、テキスト、指標、メディア、inReplyToPostIdが含まれるので、スレッドを再構築できます。これは、無料の単一投稿エンドポイントのどれも公開していない唯一の X データであり、「このスレッドを読んで」というエージェントのタスクの多くがヘッドレスブラウザに行き着いていた理由です。
投稿の下の返信こそ、反応が生きている場所です。投稿そのものはブランドが何を言ったかを教えてくれますが、返信は人々がそれをどう思ったか、何が壊れたか、何を望んでいるか、どの不満が 4,000 件のいいねを集めたかを教えてくれます。感情分析、顧客リサーチ、インシデント監視にとって、返信こそがデータです。
同時に、アカウントなしで読むのが X で最も難しい部分でもあります。FxTwitter と vxTwitter は投稿 1 件を読みます。syndication エンドポイントも投稿 1 件です。X 自身のページは返信を後から JavaScript で読み込むので、curl には空のシェルしか返りません。公式 API は、有料枠の会話検索を通じて返信を公開しています。
リクエスト
curl -s "https://unifapi.com/tools/x/replies?id=https://x.com/NASA/status/2107237881668313108"
id には数値の投稿 ID か、完全な x.com / twitter.com の URL を渡せます。レスポンスはこうです。
{
  "post": {
    "id": "2107237881668313108",
    "text": "Time to bring them home 🌎 …",
    "author": { "handle": "NASA", "name": "NASA", "verified": true },
    "metrics": {
      "likes": 7210,
      "reposts": 846,
      "replies": 262,
      "quotes": 60,
      "bookmarks": 197,
      "views": 2823329
    },
    "conversationId": "2107237881668313108"
  },
  "replies": {
    "items": [
      {
        "id": "2107252849688424504",
        "text": "@NASA @Space_Station @SpaceX Those space suits don't look right…",
        "createdAt": "2026-10-05T23:33:22.000Z",
        "author": {
          "handle": "Troyztoys",
          "name": "Tee Crenshaw",
          "verified": true,
          "followers": 1823
        },
        "metrics": {
          "likes": 15,
          "reposts": 1,
          "replies": 0,
          "quotes": 0,
          "bookmarks": 0,
          "views": 894
        },
        "media": [],
        "conversationId": "2107237881668313108",
        "inReplyToPostId": "2107237881668313108"
      }
    ],
    "hasMore": true,
    "nextCursor": "20@"
  }
}
post は元の投稿です。replies.items は、その会話に含まれる元の投稿以外の公開投稿で、直接の返信もネストした返信も含みます。それぞれに inReplyToPostId があるので、返信への返信は親を指し、スレッドをツリーとして再構築できます。
ソート
sort=top(デフォルト)は、いいね、リポスト、返信の合計で並べます。X 自身の「関連性の高い順」タブがおおよそやっていることと同じです。sort=recent は新しい順です。「反応はどうか」なら top、「直近 1 時間に何が起きたか」なら recent を使ってください。
人向けのページ /tools/x-reply-viewer には同じ 2 つの選択肢がピルとしてあり、/tools/x-reply-viewer?q=<id>&sort=recent&format=json は API とまったく同じものを返します。
ページング
返信は 1 ページ 20 件です。続きを読むには nextCursor を cursor として渡します。最初のカーソルは 20@ のような見た目のことが多く、「すでに取得したページの次の 20 件」を意味します。それ以降は X 自身の不透明なカーソルです。すべて不透明な文字列として扱ってください。
返信 262 件の投稿なら約 14 ページです。10 分あたり 20 の無料ユニットのうち 14 を使うことになるので、ヘッダーの X-RateLimit-Remaining を読み、十分集まったら止めてください。top でソートした最初のページに、重要な返信はたいてい入っています。
返信レコードに含まれるもの
| フィールド | 意味 |
|---|---|
id, url | 返信の id と正規の x.com URL |
text | 全文。先頭の @メンションは X が保存しているとおり |
createdAt | ISO 8601、UTC |
author | handle、name、verified、followers、avatarUrl、… |
metrics | likes、reposts、replies、quotes、bookmarks、views |
media | X の CDN 上の写真と動画、サイズと MP4 URL 付き |
inReplyToPostId | この返信が答えている投稿 |
conversationId | 会話のルート投稿 |
possiblySensitive | X 自身のフラグ |
形は検索、プロフィール、メディアの各エンドポイントが返す post レコードと同じなので、投稿をスコアリングする関数は返信に対してもそのまま動きます。
作れるもの 3 つ
反応のサマリー。 top のページを取得し、20 件のテキストを元の投稿と一緒にモデルに渡し、最も多い 3 つの感情とそれぞれの代表的な引用を 1 つずつ求めます。返信 20 件と呼び出し 1 回。ランキングは top ソートがすでに済ませています。
不満のフィード。 ブランドの発表に対して sort=recent を 10 分ごとにポーリングし、ポーリングの間に metrics.likes がしきい値を超えて伸びた返信を残し、人に回します。伸びているものこそ、スクリーンショットを撮られるものです。
スレッドの再構築。 全ページをたどり、id から返信へのマップを作り、各返信を inReplyToPostId に紐づけます。元の投稿への返信が深さ 1 で、残りはネストします。Markdown として描画すれば、レポート用の読みやすい会話の記録になります。
制限
- 公開返信のみ。保護されたアカウントからの返信と削除済みの返信は含まれず、そのため元の投稿の
replies数が読める数より多いことがあります。 - 無料の上限は、すべての
/tools/x/*エンドポイントの合算で訪問者ごとに 10 分あたり 20 回の照会で、検索は 2 回分として数えます。429 にはRetry-Afterと、上限を引き上げられる URL が付きます。 - 量、履歴、保証は、ワークスペースキーによる従量課金の X / Twitter API で、フィールド名は同じです。
FAQ
Twitter API なしでツイートへの返信を取得できますか?
はい。上のエンドポイントは、ログインもアカウントもキーもなしに、無料で公開返信を読みます。訪問者ごとのレート制限付きです。デフォルトでは JSON を、format=md で Markdown を返します。
X では返信 262 件なのに、200 件しか見えないのはなぜですか?
保護されたアカウントからの返信、削除された返信、著者が非表示にした返信があるからです。元の投稿のカウントは X のもので、読める集合は公開されているものです。
引用投稿は含まれますか?
いいえ。引用は返信ではなく別の投稿です。/tools/x/search?q=<post url> で投稿の URL を検索すると見つかります。
返信をモデル向けのテキストとして読めますか?
はい。format=md は、元の投稿と各返信を、著者、テキスト、指標、URL 付きの Markdown ブロックとして返します。