
Der minimal tragfähige Agent-Stack für Skills mit öffentlichen Daten

Aktualisiert
Ein Architektur-Leitfaden für Public-Data-Skills: Agent-Client, MCP-Runtime, einheitliche Datenschicht, Observability, Kostenkontrolle, Fehlergrenzen.
Kurz gesagt: Dieser Architektur-Artikel ist die zentrale Anlaufstelle für Teams, die Skills aus Chat-Threads in dauerhafte Produkte verwandeln: Agent-Client, MCP-Laufzeit, Schicht für öffentliche Daten und Observability.
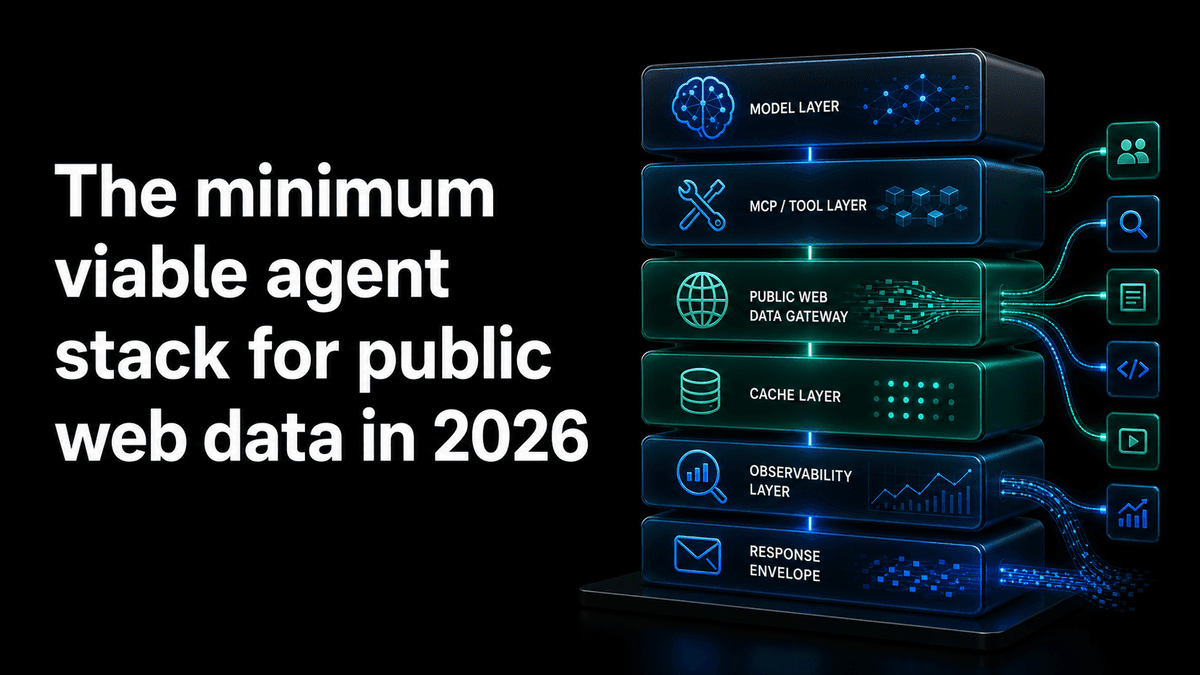
Um einen produktiven Workflow aufzubauen, der auf öffentliche Daten zugreift, braucht es vier Bausteine und einige Leitplanken: ein Agent-Produkt, das gut im Umgang mit Tools ist, eine MCP-Laufzeit, eine vereinheitlichte Schicht für öffentliche Daten, Observability über das, was der Agent tatsächlich aufgerufen hat, sowie Kontrollen, die Kosten und Umfang inspizierbar halten. Alles darüber hinaus muss sich seinen Platz verdienen.
Das ist der Stack, den wir für Skills mit öffentlichen Daten wie KOL-Pricing, Creator-Discovery, Social Listening, Wettbewerbsanalyse und Marktforschung behalten würden. Er ist bewusst schlanker als ein vollständiges Agent-Plattform-Diagramm, denn die meisten Teams überdimensionieren die erste Version.
Der Referenz-Stack
| Schicht | Wahl für die Entwicklung | Wahl für die Produktion | Was sie beweisen muss |
|---|---|---|---|
| Agent-Produkt | Claude, ChatGPT Custom-MCP-Apps, OpenClaw, Hermes, Codex, Claude Code, Cursor, VS Code | Die Agent-Laufzeit, der Ihr Team bereits vertraut | Kann Tools aufrufen, Ergebnisse prüfen und Ausgaben überarbeiten |
| MCP-Laufzeit | Gehostete MCP-URL im Client | Langlebiger MCP-fähiger Agent-Dienst | Stabile Authentifizierung, Tool-Discovery, Tool-Ausführung |
| Schicht für öffentliche Daten | UnifAPI MCP und HTTP-APIs | Dieselbe, mit expliziten Scopes und Budgets | Ein Envelope, ein Abrechnungsmodell, Live-Daten aus öffentlichen Quellen |
| Observability | Browser-/Client-Transkript plus Logs | Tool-Call-Traces, Datensatzanzahl, Latenz, Kosten | Kann nachvollziehen, warum sich die Antwort geändert hat |
| Persistenz | Ergebnis manuell kopieren | Eingaben, Datensatz-IDs, Ausgaben und Entscheidungen pro Lauf speichern | Kann Läufe über die Zeit vergleichen |
Die ersten vier Schichten sind erforderlich. Persistenz wird erforderlich, sobald der Workflow wiederholt wird oder kundenseitig sichtbar ist. Bis dahin ist die schnellste Lernschleife meist ein Agent-Thread plus ein klarer Skill-Prompt.
Schicht 1: das Agent-Produkt
Das Modell wählt die Tools aus; die Laufzeit führt sie aus. Moderne Agent-Produkte können mehrstufige Tool-Nutzung ohne viel Prompting bewältigen, wenn Aufgabe und Tool-Oberfläche klar sind. Nutzen Sie für die Entwicklung das Produkt, in dem Ihr Team ohnehin lebt: Codex für Repo-native Arbeit, Claude Code für Terminal- und Projekt-Automatisierung, Claude Desktop oder Claude.ai für Operator-Workflows, Cursor, wenn die Arbeit im Editor beginnt.
Bauen Sie nicht zuerst eine eigene GUI, es sei denn, der Workflow hat bereits stabile Eingaben und einen wiederkehrenden Käufer. Eine GUI friert den Workflow zu früh ein. Ein Skill erlaubt dem Operator, Rückfragen zu stellen, den Zielmarkt zu ändern, eine tiefere Suche anzufordern oder den Agent zu bitten, sein Vertrauen zu erläutern, bevor irgendetwas produktisiert wird.
Schicht 2: MCP-Laufzeit
MCP ist die Verbindungsschicht zwischen Agent und externen Systemen. Für Skills mit öffentlichen Daten muss die Laufzeit Tools bereitstellen, OAuth- oder Bearer-Authentifizierung handhaben, den Verbindungsstatus anzeigen und dem Agent erlauben, verfügbare Operationen zu inspizieren.
Remote-HTTP-MCP-Server sind inzwischen die Standardform für cloud-gehostete Dienste in den großen Agent-Clients, die wir geprüft haben. Die Referenz von Claude Code bezeichnet HTTP als empfohlene Option für entfernte Cloud-Server, wo verfügbar. Cursor dokumentiert Streamable HTTP als Remote-Transport mit OAuth. Die MCP-Dokumentationsseite von OpenAI zeigt, wie Codex einen Streamable-HTTP-MCP-Server per URL hinzufügt.
Für UnifAPI bedeutet das: Der Skill sollte den Nutzer nicht auffordern, einen lokalen Scraper zu installieren oder Plattform-API-Schlüssel einzufügen. Er sollte ihn auffordern, https://mcp.unifapi.com zu verbinden, sich bei Bedarf per OAuth zu authentifizieren und den Agent Operationen über den MCP-Katalog entdecken zu lassen.
Schicht 3: vereinheitlichte Schicht für öffentliche Daten
Die vereinheitlichte Daten-API ist der größte einzelne Hebel in diesem Stack. Wenn Ihr Agent am Ende einen Wrapper für Twitter/X, einen anderen für Reddit, einen weiteren für YouTube und eine Tabelle für KOL-Pricing aufruft, haben Sie ein Multi-Vendor-Integrationsproblem gebaut, bevor Sie überhaupt den Agent-Workflow gebaut haben.
Schieben Sie diese Komplexität hinter ein einziges Gateway. Der Live-Katalog von UnifAPI deckt TikTok, LinkedIn, Instagram, YouTube, Twitter/X, Threads, Reddit und Hacker News hinter einem MCP-Server und einem HTTP-Kontrakt ab. Der Agent-Prompt wird zu „führe den KOL-Pricing-Skill aus" statt „rufe profile_api, comments_api, search_api auf und füge dann eine Tabelle zusammen."
Die zentrale Produktanforderung ist nicht nur Abdeckung. Es ist konsistentes Antwortverhalten: vorhersehbare Request-IDs, eine Daten-Payload, optionale Paginierung, Abrechnungs-Metadaten und normalisierte Fehler. Genau diese Details erlauben es dem Agent, sich von einem Teilausfall zu erholen, statt eine Geschichte zu erfinden.
Schicht 4: Observability und Replay
Ohne Observability debuggen Sie blind. Das absolute Minimum für einen produktiven Agent mit öffentlichen Daten ist ein Trace pro Lauf, der den Nutzer-Prompt, jeden Tool-Call, die Argumente, den Antwort-Status, die Dauer, die Anzahl zurückgegebener Datensätze, die Anzahl abgerechneter Datensätze, die Modell-Ausgabe und die finale Entscheidung festhält.
Sobald Sie einen Lauf erneut abspielen können, hören Regressionen auf, mysteriös zu sein. Ein langsamer Lauf ist meist eines von vier Dingen: Modell-Latenz, Latenz der öffentlichen Quelle, ein Prompt, der zu breit ausfächert, oder eine Retry-Schleife, ausgelöst durch mehrdeutige Operationsauswahl. Der Trace sollte Ihnen sagen, welches es war.
| Was zu loggen ist | Warum es wichtig ist |
|---|---|
| Ursprüngliche Nutzeraufgabe | Erklärt Absicht und Rahmenbedingungen |
| Ausgewählte Operation | Zeigt, ob die Discovery die richtige Quelle wählte |
| Query-/Body-Argumente | Erklärt, warum eine Quelle diese Datensätze lieferte |
| Datensatzanzahl und Abrechnung | Macht Kosten vorhersehbar |
| Paginierungsentscheidungen | Zeigt, ob der Lauf zu früh oder zu spät stoppte |
| Vertrauen und Annahmen | Hält die finale Antwort prüfbar |
Schicht 5: Persistenz
Persistieren Sie nicht am ersten Tag alles. Persistieren Sie das Minimum an Fakten, das einem künftigen Nutzer erlaubt, die Entscheidung zu verstehen oder zu vergleichen. Speichern Sie für einen KOL-Pricing-Lauf die Kampagnen-Eingabe, die Creator-Handles, öffentliche Datensatz-IDs oder URLs, geschätzte Spannen, Vertrauen, Annahmen und finale Notizen. Speichern Sie für Social Listening Query, Quelle, Zeitfenster, Top-Datensätze, Themen und eine Zusammenfassung.
Die Falle ist, rohe Tool-Ausgaben zu speichern, ohne den Entscheidungskontext zu speichern. Ein künftiger Leser muss wissen, warum der Agent diese Datensätze abgerufen hat und welche Entscheidung die Antwort eigentlich unterstützen sollte.
Kostenkontrolle
Agents für öffentliche Daten brauchen explizite Kostenkontrollen, weil Tool-Nutzung schnell ausfächern kann. Ein guter Skill setzt ein standardmäßiges Datensatz-Budget, erklärt, was ein leichter Lauf kostet, und fragt nach, bevor er vom Screening zur Tiefenrecherche übergeht.
| Kontrolle | Standard für eine erste Version |
|---|---|
| Datensatz-Limit | 20–50 Datensätze pro Quelle, bevor um Fortsetzung gebeten wird |
| Plattform-Umfang | Mit der primären Plattform beginnen, nur bei Bedarf anreichern |
| Paginierung | Stoppen, wenn marginale Datensätze die Antwort nicht mehr ändern |
| Tiefenanalysen | Explizite Nutzerbestätigung für Multi-Quellen-Erweiterung verlangen |
| Ausgabe | Belege und Annahmen zurückgeben, damit der Nutzer entscheiden kann, ob mehr Daten den Aufwand wert sind |
Wo dieser Stack noch scheitert
Erstens: OAuth in die eigenen SaaS-Accounts des Nutzers ist eine andere Integrationskategorie. Gmail, Linear, Notion, HubSpot und Salesforce sind nutzerautorisierte private Daten. UnifAPI ist für öffentliche Daten. Nutzen Sie eine Connector-Plattform oder einen zweiten MCP-Server für die privaten Systeme des Nutzers.
Zweitens: Langlaufende Hintergrund-Workflows brauchen Orchestrierung außerhalb des Chat-Threads. Ein wöchentliches Digest, ein nächtlicher Crawl oder ein stündlicher Monitor sollte einen Scheduler, eine dauerhafte Queue und einen Benachrichtigungspfad nutzen. Der Skill kann die Aufgabenform definieren, aber die produktive Auslieferung braucht eine Ausführungsschicht.
Drittens: Browser-Workflows sind weiterhin nötig, wenn die Website selbst die Schnittstelle ist. Wenn der Agent sich in ein Portal einloggen, ein Formular ausfüllen oder ein Dashboard navigieren muss, nutzen Sie einen Browser-Agent-Stack. Wenn der Agent wiederholbare öffentliche Daten braucht, beginnen Sie mit APIs.
Eine Baureihenfolge, die Sie ehrlich hält
Beginnen Sie mit einem Skill in einem Agent-Client. Fügen Sie UnifAPI MCP hinzu. Führen Sie fünf echte Aufgaben von Hand aus. Inspizieren Sie die Datensätze und finalen Ausgaben. Fügen Sie ein Kostenlimit hinzu. Fügen Sie Trace-Logging hinzu. Erst dann produktisieren Sie den Workflow hinter einer App-UI oder einem geplanten Job.
Die Reihenfolge zählt, weil sie verfrühte Infrastruktur verhindert. Wenn der Skill in einem transparenten Agent-Thread keine nützliche Antwort liefern kann, wird eine schönere UI das nicht beheben. Wenn er in einem Thread eine nützliche Antwort liefern kann, wird der Weg zur Produktisierung viel klarer.
Geprüfte Quellen
Dieser Architektur-Leitfaden wurde am 2. Juni 2026 anhand der offiziellen Model-Context-Protocol-Einführung, der OpenAI-Docs-MCP-Seite, der Claude-Code-MCP-Referenz und der MCP-Dokumentation von Cursor aktualisiert.
Was Sie als Nächstes lesen sollten
Tool-Design für den MCP-Katalog – taucht in die MCP-Operationsschicht ein.
Vereinheitlichter Antwort-Envelope – behandelt den Datenkontrakt, von dem der Stack abhängt.
Agent-First-Skills für öffentliche Daten – verbindet die Architektur zurück mit nutzerseitigen Skills.