
MCP-Katalog-Tool-Design: von Dutzenden Endpunkten zu einem großen Operationsset

Aktualisiert
Wie UnifAPI von Dutzenden Endpunkten zu einem großen Operations-Set hinter drei MCP-Katalog-Tools wuchs – und warum Skills die Komplexität verbergen.
Kurz gesagt: Diese Engineering-Notiz erklärt, warum UnifAPI einen großen Operationskatalog über drei MCP-Tools bereitstellt und warum Skills die nutzerseitige Schicht über diesem Katalog sind.
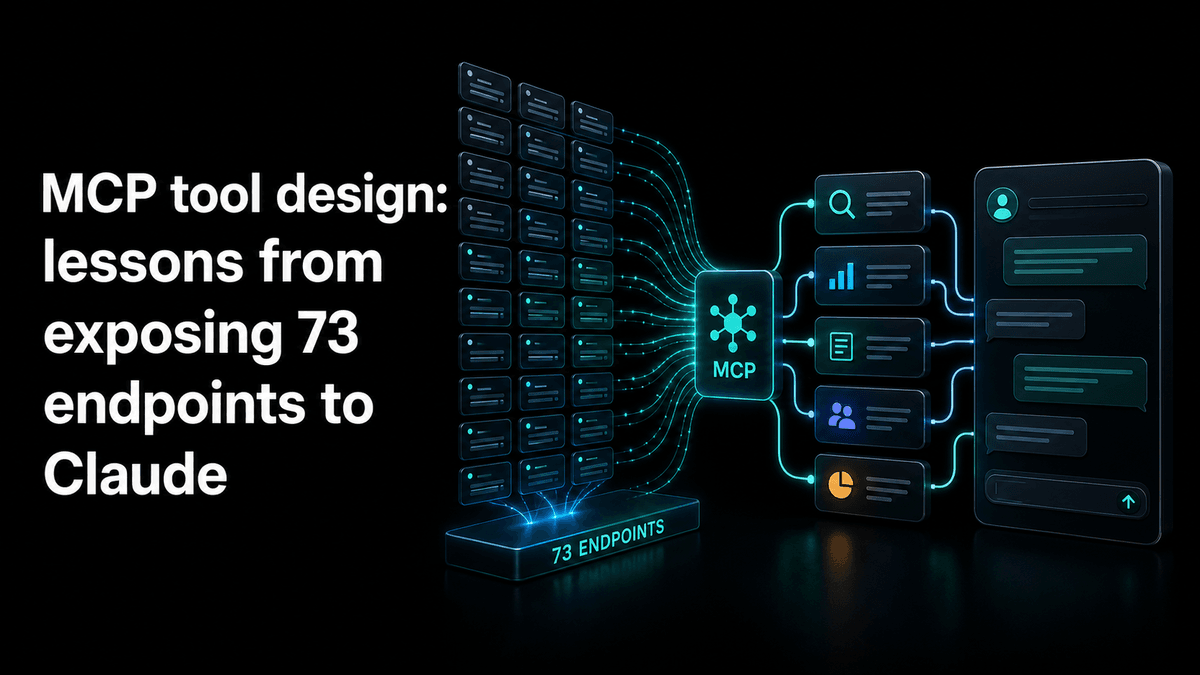
Der erste MCP-Katalog von UnifAPI stellte 73 Endpunkte bereit. Der aktuelle Katalog stellt ein großes Operationsset über Live-APIs für öffentliche Daten mittels dreier MCP-Tools bereit: list_operations, get_operation und call_api. Das gut zu machen ist schwieriger, als es aussieht: Das Modell muss immer noch die richtige Operation finden, das Schema inspizieren und einen sauberen Aufruf tätigen. Das haben wir über Benennung, Beschreibungen, Parameter-Schemas und die Fehlermodi gelernt, die erst auftauchen, wenn man Dutzende Operationen live hat.
Warum ein großes Operationsset das Produkt verändert
Bei 5–10 Operationen „funktioniert MCP einfach" — das Modell durchsucht den Katalog, wählt eine aus und ruft sie auf. Bei 20–30 beginnt die Operationsbenennung zu zählen; man sieht, wie das Modell gelegentlich den knapp-aber-falschen Pfad wählt. Bei 50+ wird der Katalog selbst tragend.
Die Anzahl wird weiter wachsen, aber die Produktlektion ist bereits klar: Mit steigender Operationsanzahl werden Skills wichtiger, weil sie die Katalog-Navigation hinter einem Aufgabenergebnis verbergen.
Operationsbenennung: agent-lesbar, nicht menschen-lesbar
Unsere Operationslabels folgen einem Muster: Plattform, Verb, Substantiv. TikTok search videos, Reddit get post, LinkedIn search people. Ausführlich, aber eindeutig. Das Modell wählt die richtige Operation, weil der Name wie ein Satzfragment liest, nicht wie ein Code-Identifier.
Wir haben früh kürzere Konventionen ausprobiert — tiktok.search, reddit.post — und sahen, wie das Modell bei nahen Paaren falsch wählte („search" auf TikTok vs. „search" auf Reddit, wenn der Nutzer „search" sagte). Das Plattform-Präfix im Operationstitel macht das eindeutig, ohne dass das Modell darüber nachdenken muss.
Beschreibungen sind der Prompt
Jede Operationsbeschreibung ist ein oder zwei Sätze. Das Modell sieht sie während Discovery und Inspektion. Zwei Muster, die ihre Tokens verdienen: Mit der Verb-Objekt-Zusammenfassung in den ersten 12 Wörtern beginnen und mit einem Use-When-Hinweis enden.
Gut: „Search TikTok for videos matching a keyword or hashtag. Use when the user wants short-video discovery on a topic." Schlecht: „This endpoint allows you to query the TikTok platform and retrieve a paginated list of videos that match a search term, optionally filtered by various parameters including ..." Die zweite ist technisch vollständiger und ist der falsche Kompromiss in einem großen Katalog.
Parameter-Schemas: flach halten
call_api nimmt ein flaches Objekt: path, method, query und body. Pflichtfelder zuerst, optionale danach. Der Grund ist einfach: Verschachtelte JSON-Schemas verwirren den Tool-Call-Generator des Modells. Wir haben beobachtet, wie Claude einen Parameter korrekt versteht und ihn dann auf der falschen Verschachtelungsebene ausgibt, weil das Schema verzweigt aussah.
Wenn eine Operation wirklich polymorphe Eingaben braucht (Suche nach Keyword ODER nach Hashtag), muss get_operation ein konkretes Aufrufbeispiel zeigen. Ein konkretes Beispiel schlägt ein verzweigtes Schema jedes Mal.
Was wir falsch gemacht haben
Drei Fehler, die es wert sind, benannt zu werden. Erstens ließen wir Twitter und Reddit fast identische Beschreibungen für ihre jeweiligen Such-Operationen haben, und das Modell begann, eine zu wählen, wenn der Nutzer ausdrücklich nach der anderen fragte. Behoben, indem jede Beschreibung ihre Plattform im ersten Satz explizit benennt.
Zweitens gaben wir eine Zeit lang Quell-Fehlermeldungen direkt durch. Einige davon verweisen auf plattformspezifische Konzepte, die das Modell nicht versteht, und der Agent geriet in eine Schleife beim Versuch, ein Problem zu beheben, das unser Envelope verbarg. Behoben, indem wir Fehler in ein geschlossenes Vokabular normalisierten, etwa unauthorized, validation_error, invalid_id, not_found, rate_limited und upstream_unavailable.
Drittens dokumentierten wir die Paginierung bei einigen Operationen unzureichend, und das Modell rief in jeder Schleife erneut ab Cursor 0 auf, statt weiterzurücken. Behoben, indem wir den Paginierungskontrakt in den inspizierten Operationsdaten selbst ausbuchstabierten, nicht nur in der Spezifikation.
Offene Fragen
Ab welchem Punkt partitionieren wir den Katalog? Ein großes Operationsset passt heute hinter einen MCP-Server, aber der Katalog braucht womöglich irgendwann Kategorie-Filter oder kategoriespezifische Server, damit das Modell nur lädt, was es braucht.
Wir kennen die richtige Antwort noch nicht. Wenn Sie heute Agents ausliefern, die viele UnifAPI-Operationen konsumieren, möchten wir hören, wie die Latenz der Operationsauswahl bei Ihnen aussieht — schreiben Sie uns an hello@unifapi.com.
Was Sie als Nächstes lesen sollten
Vereinheitlichter Antwort-Envelope – verbindet Tool-Discovery mit dem Antwortkontrakt.
UnifAPI MCP verbinden – zeigt den operatorseitigen Setup-Pfad.
Entwickler-Ressourcen – sammelt die maschinenlesbaren Spezifikationen und Dokumentationen.