
UnifAPI vs TinyFish: Skills de datos públicos frente a agentes de navegador

Actualizado
Los agentes de navegador tipo TinyFish operan sitios web; UnifAPI da datos públicos estructurados y Skills vía MCP. Cuándo usar cada uno.
En resumen: este artículo apunta a las búsquedas de alternativas a TinyFish replanteando la elección como flujo de trabajo de navegador frente a registros de datos públicos estructurados.
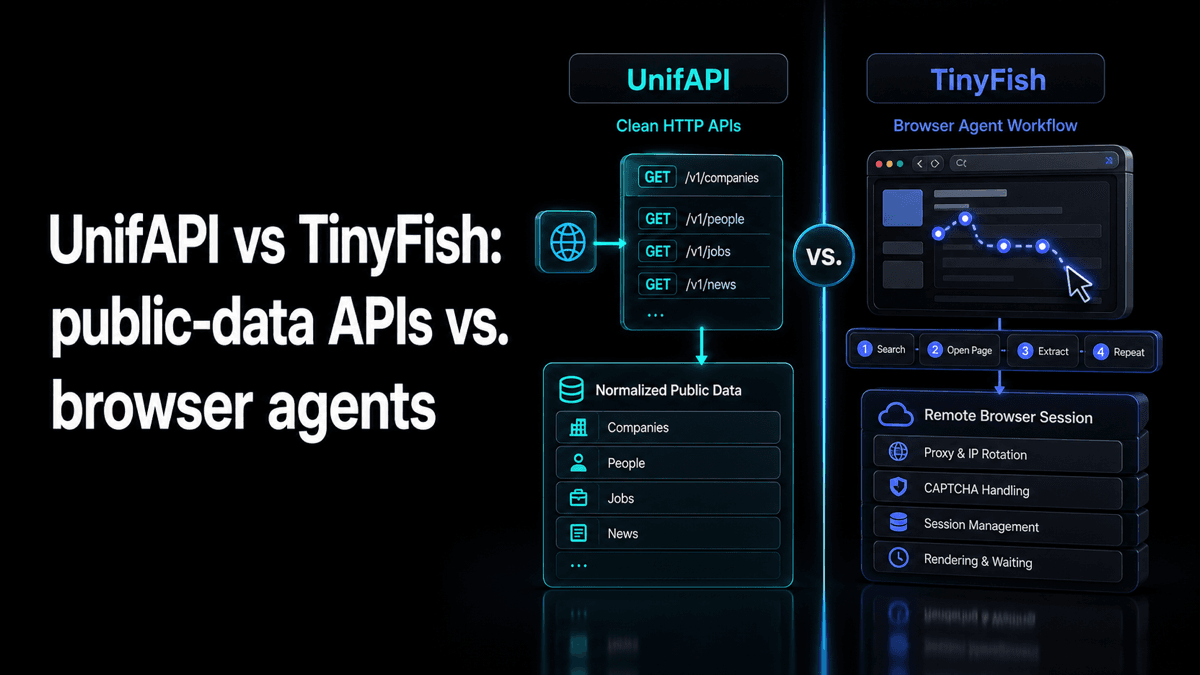
TinyFish y UnifAPI responden a la misma pregunta: ¿cómo usa la web un agente AI sin que un humano copie y pegue páginas en un prompt? La respuesta se divide en dos capas muy distintas. Los productos al estilo de TinyFish son infraestructura de agente de navegador: APIs de búsqueda, fetch, navegador y agente que pueden renderizar páginas, dirigir flujos de trabajo, rellenar formularios y devolver resultados extraídos. UnifAPI es una capa de datos públicos: registros nativos de plataforma para evidencia social y de la web abierta, normalizados detrás de MCP y una sola envoltura de respuesta.
Si buscas una alternativa a TinyFish, la primera decisión no es proveedor contra proveedor. Es flujo de trabajo de navegador frente a API de datos estructurados. Elige TinyFish cuando el agente realmente tenga que operar un sitio web. Elige UnifAPI cuando los datos ya tengan una superficie pública repetible y el navegador solo añadiría latencia, coste y modos de fallo.
TinyFish vs UnifAPI: la respuesta rápida
| Dimensión | TinyFish | UnifAPI |
|---|---|---|
| Abstracción central | Sesiones de Search, Fetch, Browser y ejecuciones de Agent orientadas a objetivos | Skills de datos públicos más APIs curadas detrás de MCP |
| Mejor límite | Páginas dinámicas, formularios, muros de login, flujos anti-bot y sitios sin API | Registros sociales públicos donde encajan los endpoints directos |
| Modelo de ejecución | Un navegador real renderiza, hace clic, espera y extrae | Las llamadas HTTP devuelven registros JSON normalizados |
| Unidad de precio | Sesiones de navegador, pasos, créditos o tiempo de acción según el producto | Créditos de operación: $0.001 cada uno, con mínimos publicados en OpenAPI |
| Integración del agente | MCP, SDKs, CLI y herramientas Search, Fetch, Browser, Agent | MCP primero, más endpoints OpenAPI/HTTP para datos públicos nativos de plataforma |
| Cuándo gana | La tarea necesita interacción con el sitio | La tarea necesita datos públicos repetibles a volumen |
Para qué está optimizado TinyFish
Las plataformas de navegador al estilo de TinyFish suelen exponer unas pocas superficies: resultados de búsqueda, fetch renderizado, sesiones de navegador remoto y ejecuciones de agente orientadas a objetivos. Esa es una forma potente para tareas en las que una API normal no basta.
Esa es una forma potente para tareas en las que una API normal no basta: extraer datos de un portal de un proveedor, rellenar un formulario de cotización de seguros, consultar un catálogo dinámico o usar un sitio que solo expone los datos correctos tras JavaScript, credenciales o varios clics. TinyFish intenta hacer el navegador lo bastante programable para agentes en producción.
El compromiso es que un flujo de trabajo de navegador sigue siendo un flujo de trabajo. El agente tiene que cargar páginas, esperar al renderizado, recuperarse de los cambios en la interfaz y gastar créditos por paso o por tiempo de sesión de navegador. Cuando un navegador es necesario, ese coste es racional. Cuando los datos objetivo ya están disponibles como un registro público estructurado, el navegador suele ser la abstracción equivocada.
Para qué está optimizado UnifAPI
UnifAPI parte de la suposición contraria: la mayoría de los flujos de trabajo de agentes con datos públicos no deberían abrir un navegador en absoluto. Un agente de social listening debería llamar a TikTok, Reddit, YouTube, LinkedIn, Instagram, Twitter/X o Threads a través de endpoints estables. Debería recibir registros con paginación, metadatos y errores predecibles. No debería razonar sobre nodos del DOM.
La superficie del producto es deliberadamente más estrecha que la de una plataforma de navegador completa. UnifAPI no inicia sesión en las cuentas privadas del usuario, ni hace clic en botones, ni rellena formularios. Da a los agentes la capa de datos públicos: una cabecera de autenticación, una factura, una envoltura y créditos de operación de $0.001 con mínimos publicados. Para investigación de alto volumen, monitorización, descubrimiento de creadores, inteligencia competitiva y análisis de mercado, esa unidad es más fácil de presupuestar que los minutos de navegador o los pasos de agente.
Precios: créditos frente a registros
Los productos de agente de navegador suelen facturar pasos, tiempo de navegador o créditos porque están ejecutando un flujo de trabajo. UnifAPI factura registros, no pasos ni tiempo. Una llamada que devuelve 20 registros cuesta $0.02. Una página de investigación de creadores de 50 registros cuesta $0.05. La comparación no es de igual a igual: TinyFish cobra por ejecutar trabajo de navegador; UnifAPI cobra por los datos devueltos. La pregunta práctica es si tu flujo de trabajo necesita trabajo de navegador en primer lugar.
La forma de la salida importa para los agentes
La salida de TinyFish se modela en torno a tareas: resultados de búsqueda, contenido de página extraído, una URL de conexión de navegador o el resultado de una ejecución de Agent. Eso es exactamente lo que quieres cuando el trabajo del agente es operar un sitio web y devolver una respuesta final.
La salida de UnifAPI se modela en torno a registros. El agente obtiene listas de publicaciones, vídeos, perfiles, comentarios, resultados de búsqueda y metadatos de plataforma relacionados en una envoltura consistente. Eso es exactamente lo que quieres cuando el agente tiene que comparar, clasificar, filtrar, paginar, enriquecer y volver a visitar la misma fuente de datos repetidamente.
Cuándo TinyFish es la mejor opción
Elige TinyFish si el propio sitio web es la interfaz. Ejemplos: iniciar sesión en un portal de proveedores y descargar la última lista de precios; completar un formulario de cotización de varios pasos; inspeccionar un panel sin API pública; extraer de una página cargada de JavaScript donde el fetch estático falla; entregar tu propio código de Playwright a una sesión de navegador remoto sigilosa.
TinyFish también tiene sentido cuando tu producto necesita una herramienta general de acción web expuesta a un agente. El usuario dice qué quiere que se haga en un sitio, y el agente intenta navegar, hacer clic, esperar y extraer. Ese no es el carril de UnifAPI.
Cuándo UnifAPI es la mejor opción
Elige UnifAPI si tu agente necesita datos públicos de plataforma en lugar de interacción con el sitio web. Ejemplos: monitorizar menciones de marca en Reddit, TikTok, YouTube y Twitter/X; extraer perfiles de creadores y publicaciones recientes; comparar la conversación sobre un lanzamiento de producto entre las plataformas sociales soportadas; enriquecer un brief de investigación con metadatos nativos de plataforma como recuentos de interacción, comentarios, autores, marcas de tiempo y cursores de paginación.
En esos flujos de trabajo, abrir un navegador para cada fuente es caro y frágil. El agente quiere datos, no una pantalla. UnifAPI mantiene el número de integraciones en una sola y deja que el modelo gaste sus tokens en síntesis en lugar de en recuperación del navegador.
Usar TinyFish y UnifAPI juntos
La arquitectura más fuerte suele ser híbrida. Usa UnifAPI para la capa de datos públicos repetible: descubre publicaciones, perfiles, vídeos, comentarios y tendencias a través de endpoints. Usa TinyFish cuando el flujo de trabajo llega a un sitio que hay que operar como lo haría un humano: un formulario, un portal de cuenta, un catálogo protegido o una página dinámica sin superficie de datos estable.
Esa división mantiene cada herramienta honesta. UnifAPI no debería fingir ser un navegador universal. A TinyFish no se le debería forzar a gastar pasos de navegador en registros que un endpoint directo puede devolver más rápido. Pon los datos públicos detrás de APIs, pon los sitios web complicados detrás de agentes de navegador, y deja que el agente elija primero la herramienta más ligera.
En resumen
TinyFish es una opción seria para la automatización de navegador con AI. Es especialmente convincente para flujos de trabajo web autenticados, dinámicos o interactivos. UnifAPI es la mejor opción para el acceso a datos públicos estructurados donde el agente necesita registros consistentes de muchas plataformas, facturación predecible, Skills y un catálogo listo para MCP.
La pregunta decisiva es simple: ¿el agente necesita usar el sitio web, o necesita los datos que hay detrás del sitio web? Si necesita el sitio web, empieza por TinyFish. Si necesita los datos, empieza por UnifAPI.
Qué leer a continuación
UnifAPI vs Browserbase / Stagehand - compara un stack de agente de navegador estrechamente relacionado.
UnifAPI vs Firecrawl / Tavily - separa la extracción de páginas de los registros de datos públicos.
Comparar alternativas - mantiene visibles todas las páginas de posicionamiento frente a proveedores.